科学分野の基盤モデルは、多様なデータモダリティから高次元の表現を学習するが、それらが具体的に何を符号化しているのか、またその知識をどのように抽出するのかは、依然として未解明の課題である。本研究では、70億パラメータを持つゲノム基盤モデル「Evo 2」の内部表現をプローブ(解析用モデル)で解析することで、遺伝的変異の影響を正確かつ解釈可能な形で予測できることを示す。Evo 2の配列埋め込みから二次統計的構造を捉える共分散ベースのプローブを導入し、変異の種類や機能的帰結を横断して変異の病原性を予測した。この手法は、特定の領域に特化した既存の予測ツールと同等、あるいはそれ以上の性能を発揮する。予測結果を既知の生物学的メカニズムと結びつけるため、既存のアノテーションを用いて一連のプローブを学習させ、変異によってどのようなゲノム特性が損なわれるかを検出する。そして、このように分類された情報を、言語モデルを介して各変異のゲノムコンテキストと統合し、変異ごとのメカニズムに関する仮説を生成する。我々(本著者ら)の病原性予測は、変異機能の実験的測定値、臨床的浸透率、およびバイオバンクにおける疾患との関連性と相関を示した。一方、生成されたメカニズム仮説は、専門家による評価、既知のメカニズム分類、および下流の分子生物学的解析結果と整合した。ClinVarデータベースに含まれる420万件のバリアントについて、病原性スコア、機能阻害プロファイル、およびコンテキストを考慮した解釈を、「Evo Variant Effect Explorer (EVEE)」を通じてオープンリソースとして公開する。より広範な視点で見れば、この構造化されたプローブ解析アプローチは、科学の様々な分野における基盤モデルを検証し、その出力を既存の専門領域の概念と結びつけるための汎用的な枠組みを提供するものである。
webサービス
EVEE — Evo Variant Effect Explorerにアクセスする。
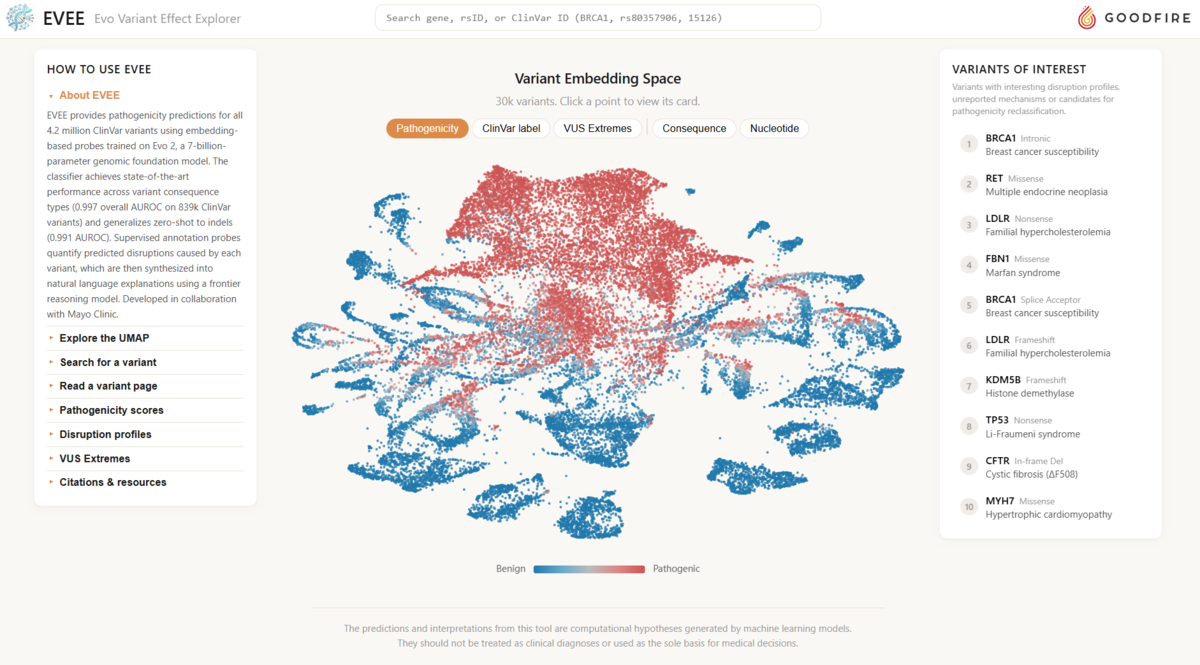
左側のメニューはHow to useで、簡単な使用マニュアルが見れる。右側のメニュー: Variants of Interestには、特徴的な予測結果を示す注目バリアント10件が掲載されている。初めてアクセスした際には、まずこれらのバリアントを選択するとEVEEでどのような情報を確認できるのか把握できる。
トップページには、Evo 2による30,000件のClinVarバリアント(2026年7月時点)の埋め込み表現を、UMAPで低次元空間へ投影した散布図が表示されている。プロット上の各点が一つのバリアントに対応し、赤色が濃いほど、EVEEによって病原性が高い(pathogenic)と予測されたバリアントを表す。
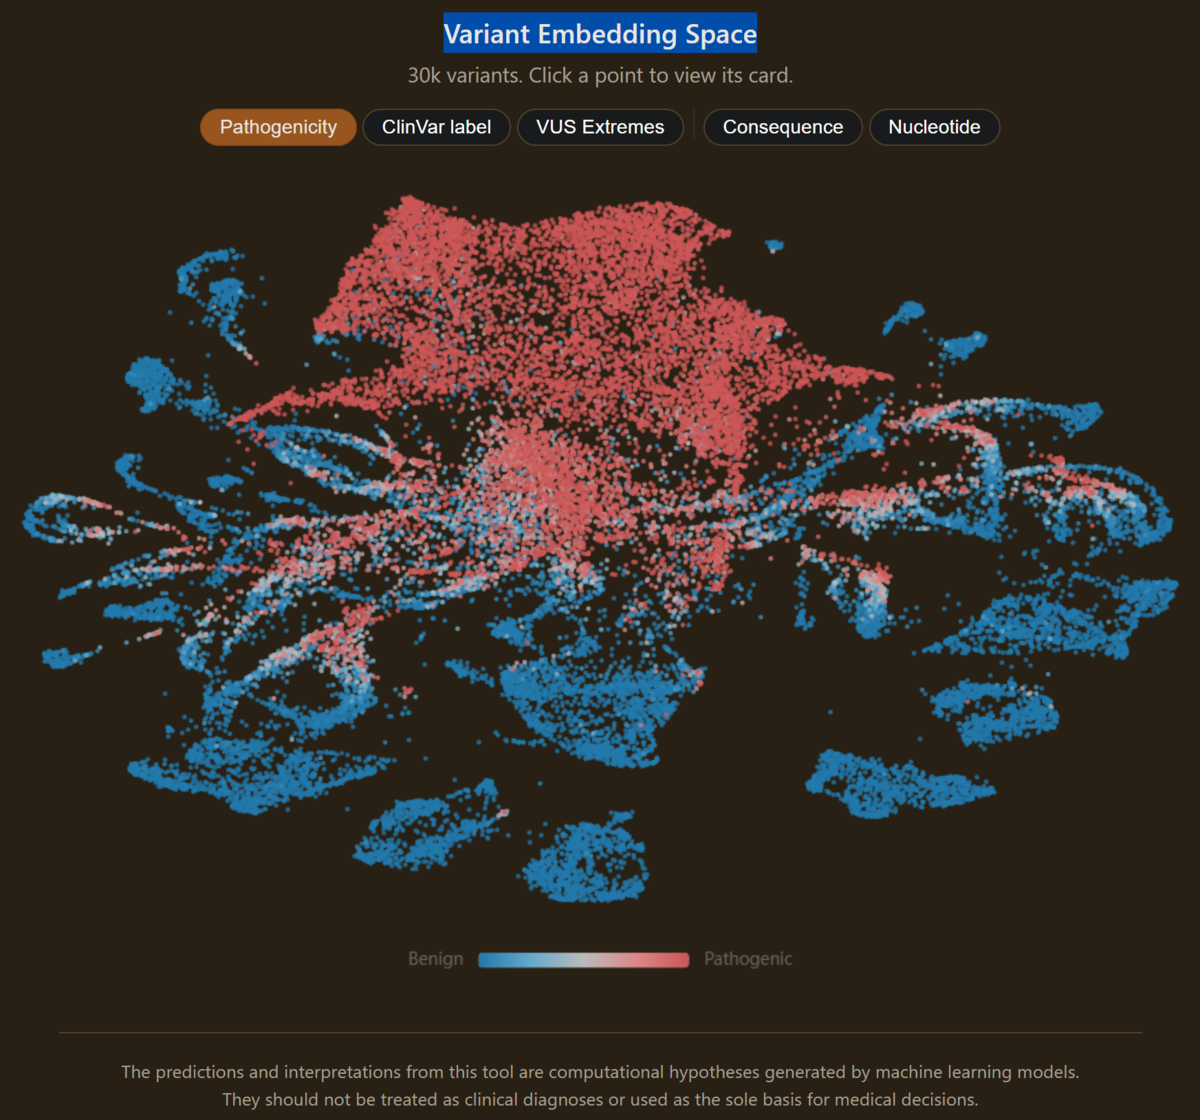
注; UMAPの3万件はEVEEが解析した全バリアント数ではなく、埋め込み空間の構造をブラウザ上で見やすく表示するための代表サンプルとなっている。実際には、EVEEは、ClinVarに登録された全420万件のバリアントについて病原性の予測を行っている。
(HPより: このツールによる予測および解釈は、機械学習モデルによって生成された計算上の仮説です。これらは臨床診断として扱われるべきではなく、医療上の意思決定の唯一の根拠として使用すべきでもありません。)
Consequenceに変更
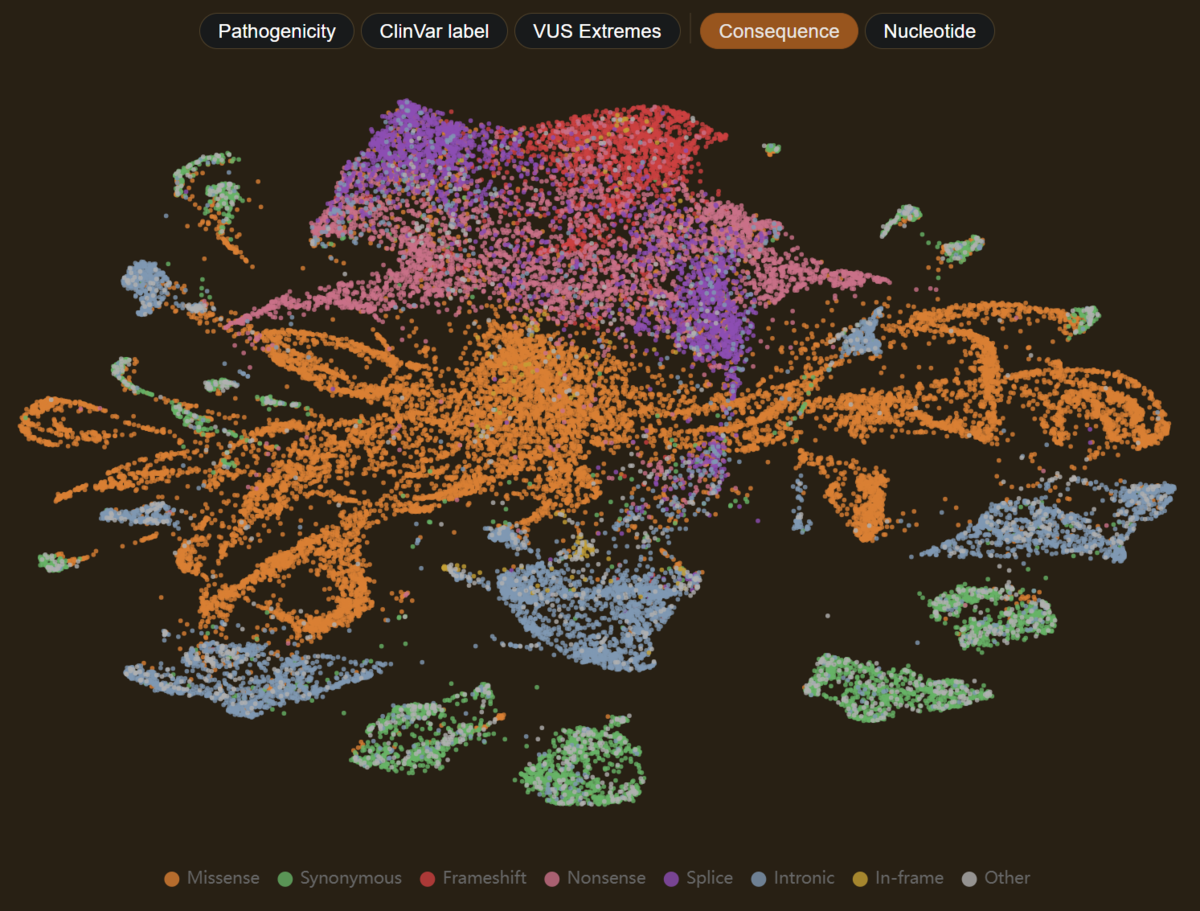
Nucleotideに変更

散布図の各点をクリックすると、そのバリアントの病原性スコアや遺伝子情報などを確認できる詳細ページへジャンプする。
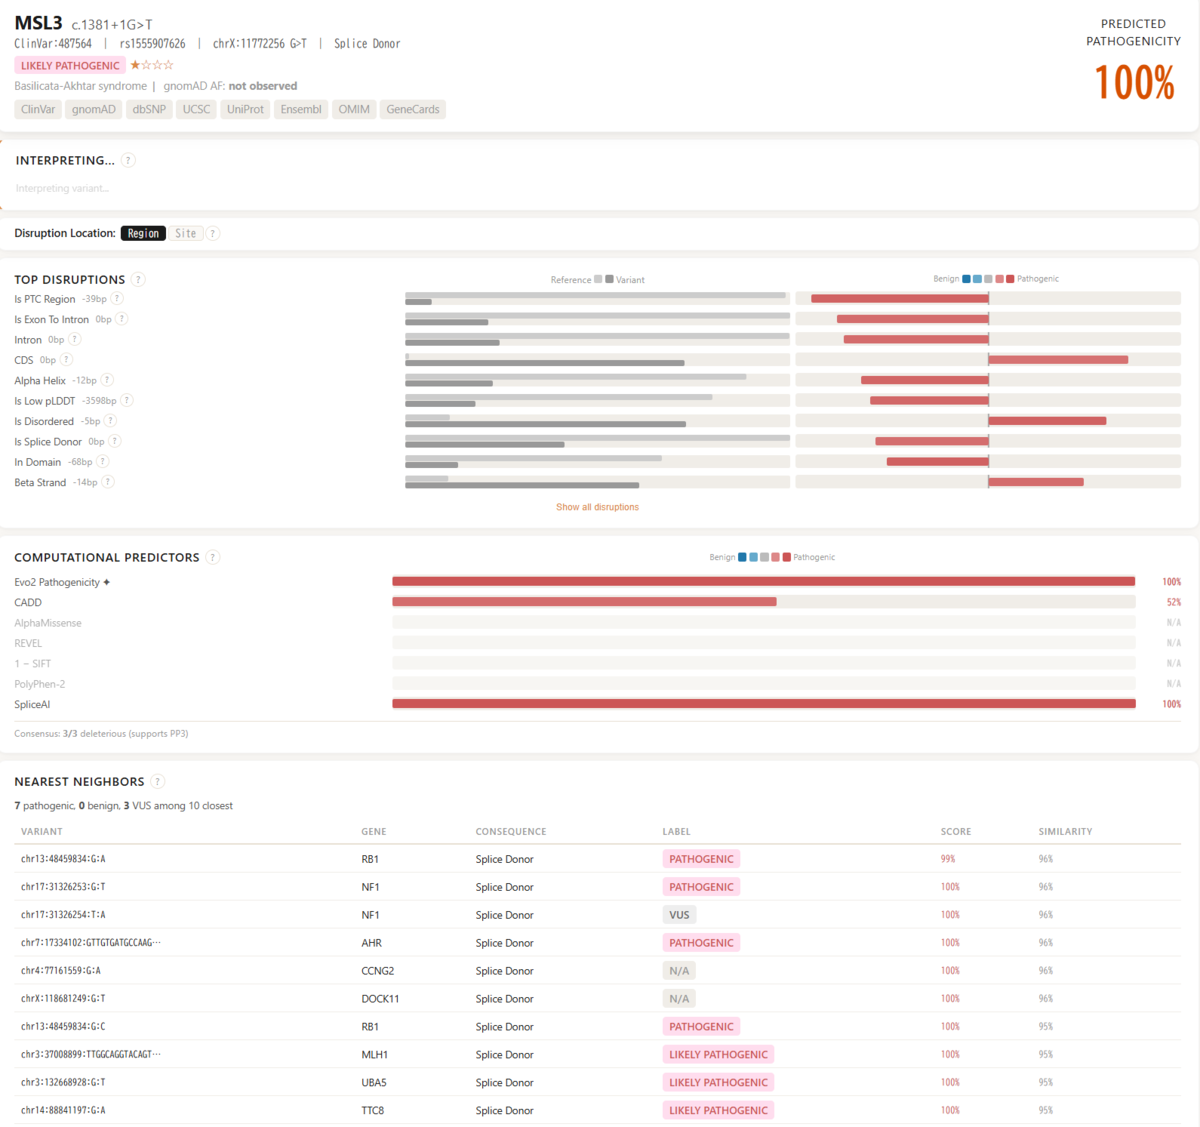
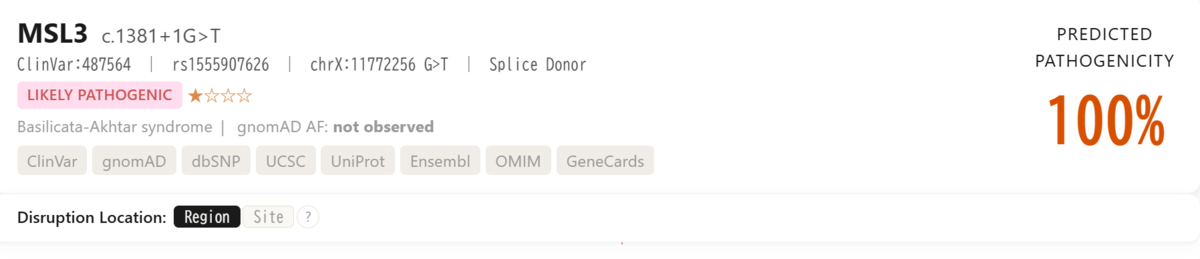
この個別ページでは、選択したバリアントについて、EVEEによる病原性予測と、その判断根拠となる特徴量をまとめて確認できる。ここでは MSL3の"c.1381+1G>Tバリアント"が表示されており、ClinVarでは「Likely pathogenic」、EVEEでは病原性が 100% と予測されている。
右上のpathogenicity scoreは、(0~100%)は、Evo 2の埋め込み表現を用いて学習された共分散プローブに基づいてたスコアで、80%を超えると病原性を示唆し、20%を下回ると良性を示唆する。ClinVar、gnomAD、dbSNP、UCSC、UniProt、Ensembl、OMIM、GeneCardsへのリンクも用意されており、関連情報を外部データベースで確認できる。
HPより: pathogenicity scoreの性能は保存性のレベルを問わず堅牢であり、BRCA1、BRCA2、TP53、およびLDLRに関するディープ・ミュータショナル・スキャン(大規模変異スキャン)のデータセットにも適用できる。
Variant Interpretation
Variant Interpretationでは、Evo2から読み出された複数のアノテーションをLLMが統合し、このバリアントによって生じると考えられる分子機序を文章で説明している。
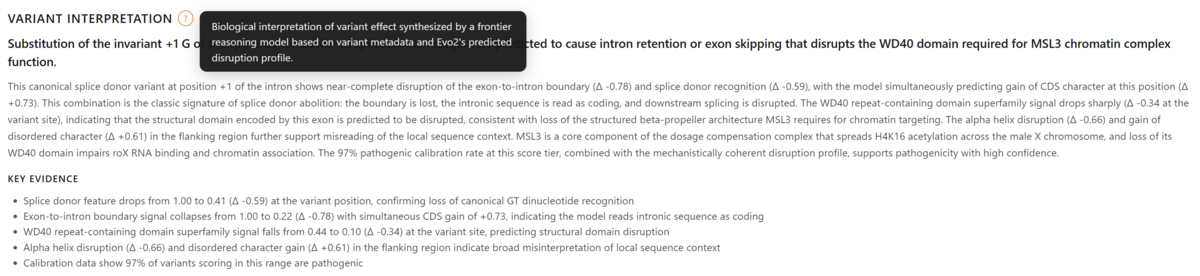
"スプライスドナー部位の保存された+1位のGが置換されると、スプライソソームによる認識が消失します。これにより、イントロン保持(intron retention)やエクソン・スキッピングが生じ、MSL3クロマチン複合体の機能に不可欠なWD40ドメインが破壊されると予測されます。"
Key Evidence
- "バリアント位置において、スプライスドナーのスコアが1.00から0.41(Δ -0.59)へと低下し、標準的なGTジヌクレオチドの認識が失われたことが確認された。"
- "エキソン・イントロン境界のシグナルが1.00から0.22(Δ -0.78)へと低下する一方で、CDS(翻訳領域)のスコアが+0.73上昇しており、モデルがイントロン配列をコード領域として読み取っていることが示唆される。"
- "バリアント部位において、WD40リピート含有ドメインスーパーファミリーのシグナルが0.44から0.10(Δ -0.34)へと低下し、構造ドメインの破壊が予測される。"
- "隣接領域におけるαヘリックスの破壊(Δ -0.66)および無秩序(disordered)な性質の獲得(Δ +0.61)は、局所的な配列コンテキストが広範に誤って解釈されていることを示している。"
- "キャリブレーションデータによると、この範囲のスコアを示すバリアントの97%が病原性である。"
Computational Predictors
Computational Predictorsでは、EVEEの結果をCADDやSpliceAIなど既存の予測法と比較できる。この例では、EVEEとSpliceAIはいずれも100% Pathogenicとなっていて、CADDもPathogenic判定となっている。
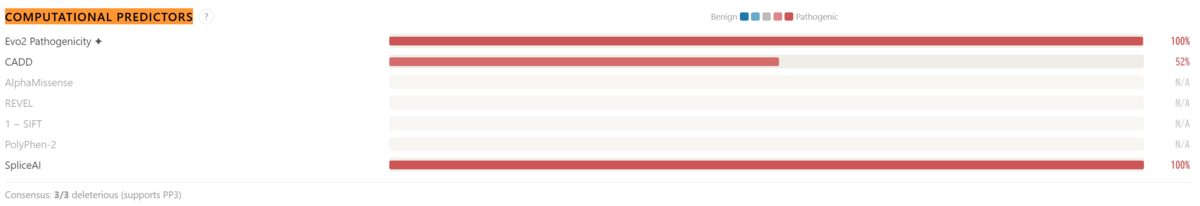
AlphaMissense、REVEL、SIFT、PolyPhen-2はスコアが表示されていない。この変異がミスセンス変異ではなくスプライス部位変異であるため。
Nearest Neighborsには、Variant Embedding空間でこのバリアントに近いバリアントが一覧表示される。
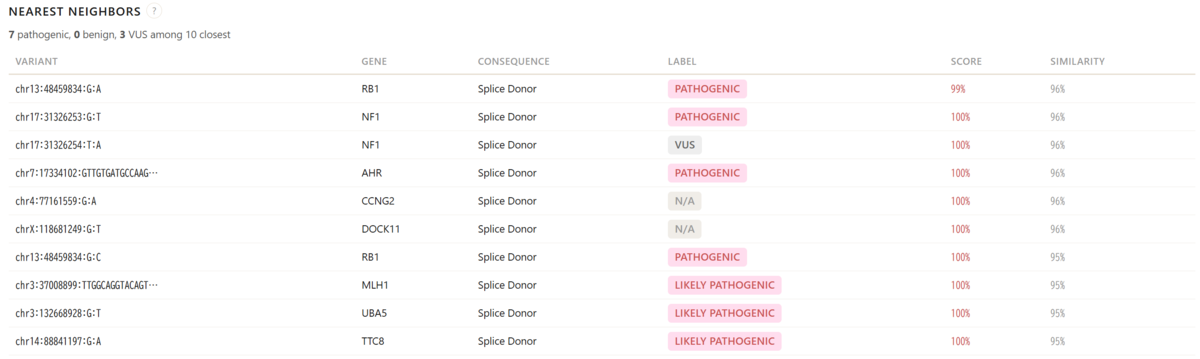
近傍の多くがpathogenicまたはlikely pathogenicに分類されている。
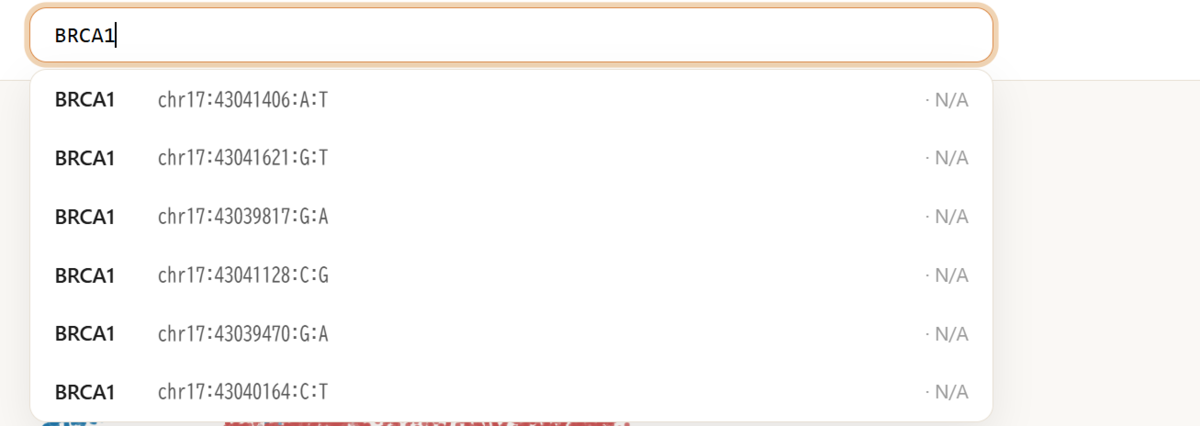
実際にバリアントを調べるには、検索バーから遺伝子名(BRCA1)、rsID(rs80357906)、またはClinVarバリアントID(15126)で検索する。
MCPを介したアクセス
MCPに対応しており、AIエージェントを通した利用もできるようになっている。
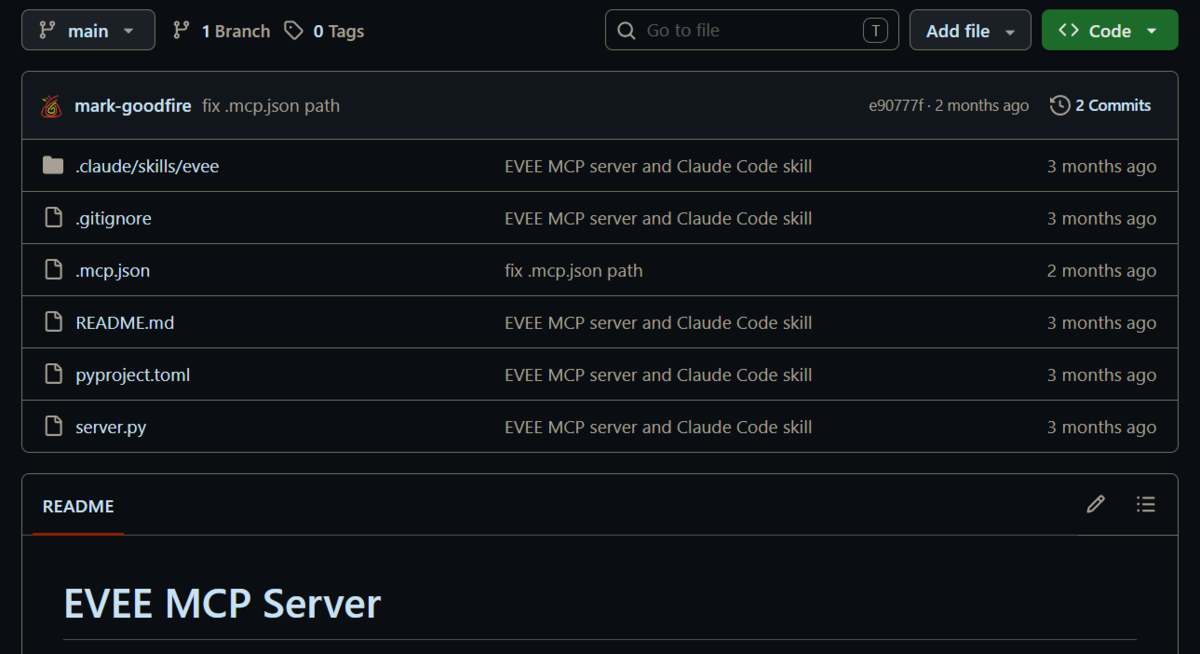
server.pyが実際のMCPサーバ本体。約600行のPythonコード。pyproject.tomlはPython依存関係の定義ファイルで、モダンなuv syncで環境を作るための設定 (参考)。.
mcp.jsonが、Claude CodeやCodexなどが、どのディレクトリをMCPサーバとして認識するかのJSONファイル。
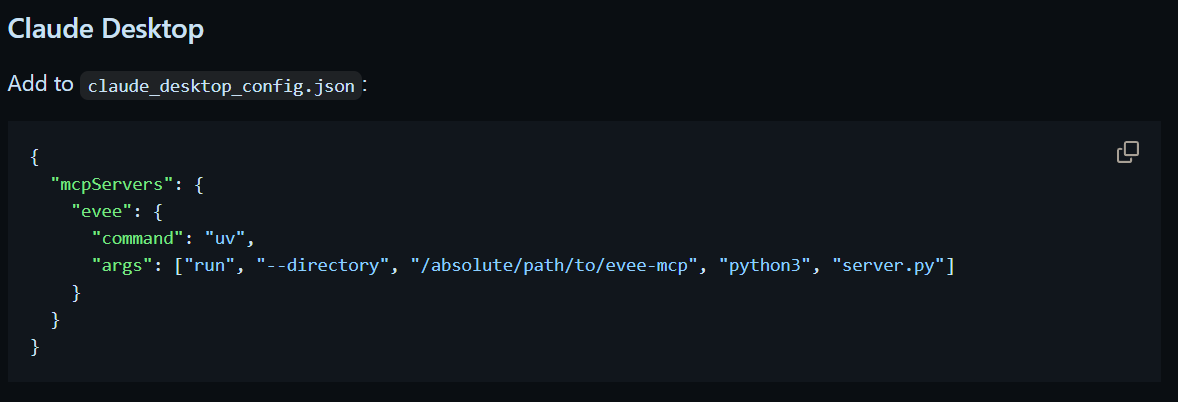
mcpServersは登録するMCPサーバ一覧、eveeはそのサーバ名、command: "uv" は起動に使うコマンド、argsはそのコマンドに渡す引数。つまり全体としては、"uv run --directory /absolute/path/to/evee-mcp python3 server.py"を実行せよ、という意味になる(参考)。よって、AIアプリにこの外部ツールはどのコマンドで起動すればよいかを教える設定ファイルとして機能する。
ここではMCPを使ってcodexからEVEEを使用してみる。Codexの入力欄で/を入力する。
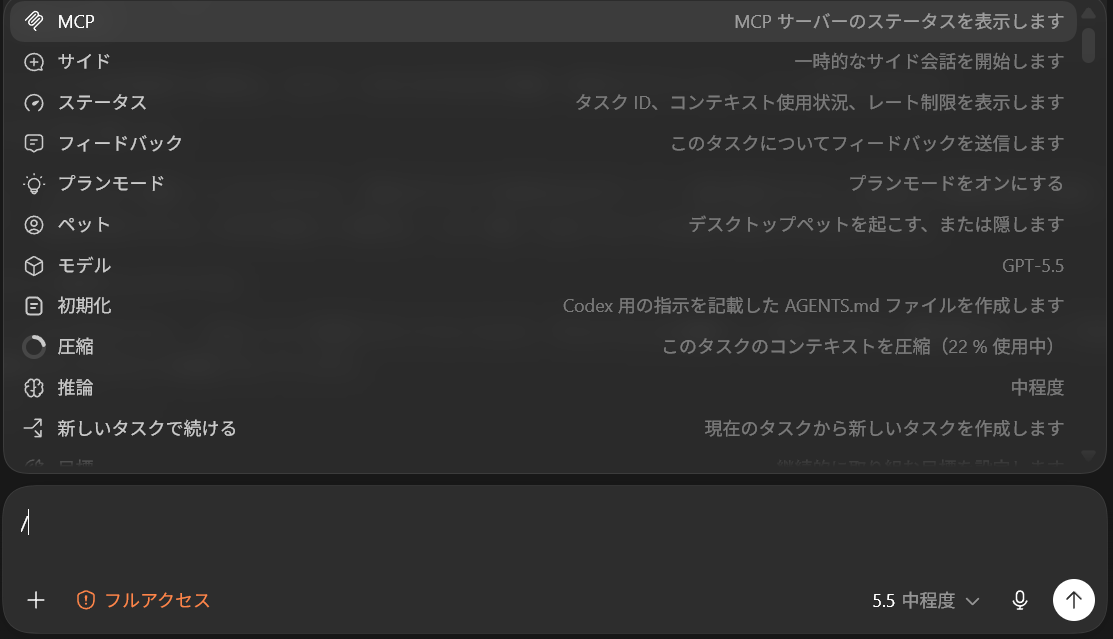
MCPを選択する (最初から/mcpでもOK))
現在のタスクで有効なMCPサーバーの一覧が表示される。各項目には認証状態と有効/無効が表示される。
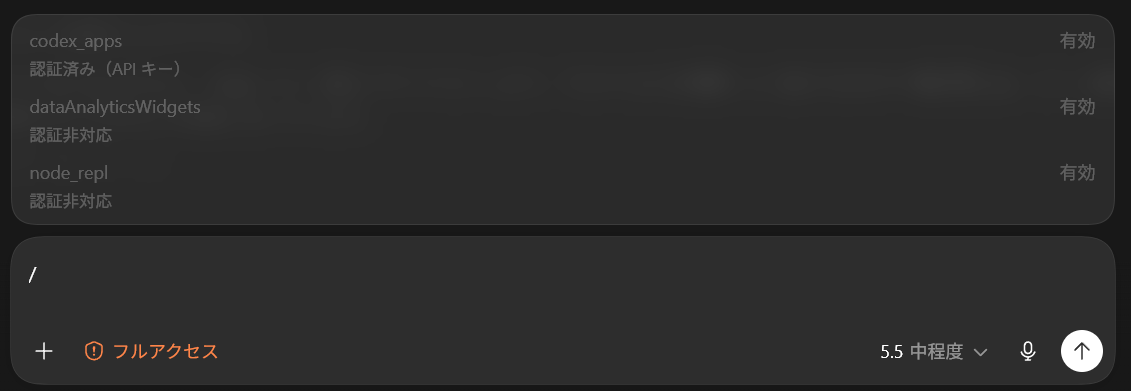
EVEEを追加した場合は、この一覧にeveeの名前が表示される。
Codexで使う場合は、Claude Desktop用のmcp.jsonを、Codexのconfig.tomlにTOML形式で用意する。具体的には、evee-mcpのリポジトリをcloneし、その場所でuv sync(依存の同期)を済ませて、uv run --directory ... python server.pyで起動できる状態にする。そのうえで、Codexの設定ファイルconfig.toml に、たとえば設定を追加する。
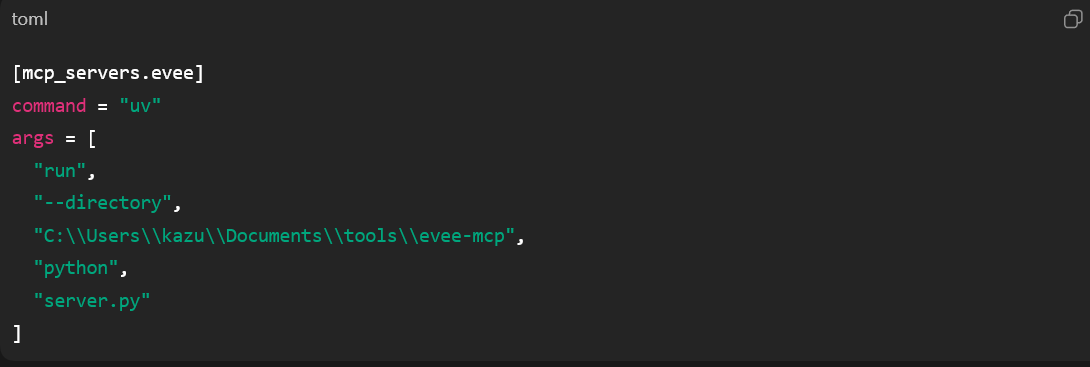
設定後にCodexを再起動すると、CodexはEVEE MCPサーバが提供するツールを認識し、会話の中で「この変異をEVEEで調べて」と頼まれたときに、そのツールを呼び出せるようになる。
MCPの追加自体、codex自体に作業させるのが早い。レポジトリのURLを指定して、MCPとして追加するように指令するだけで動作する。
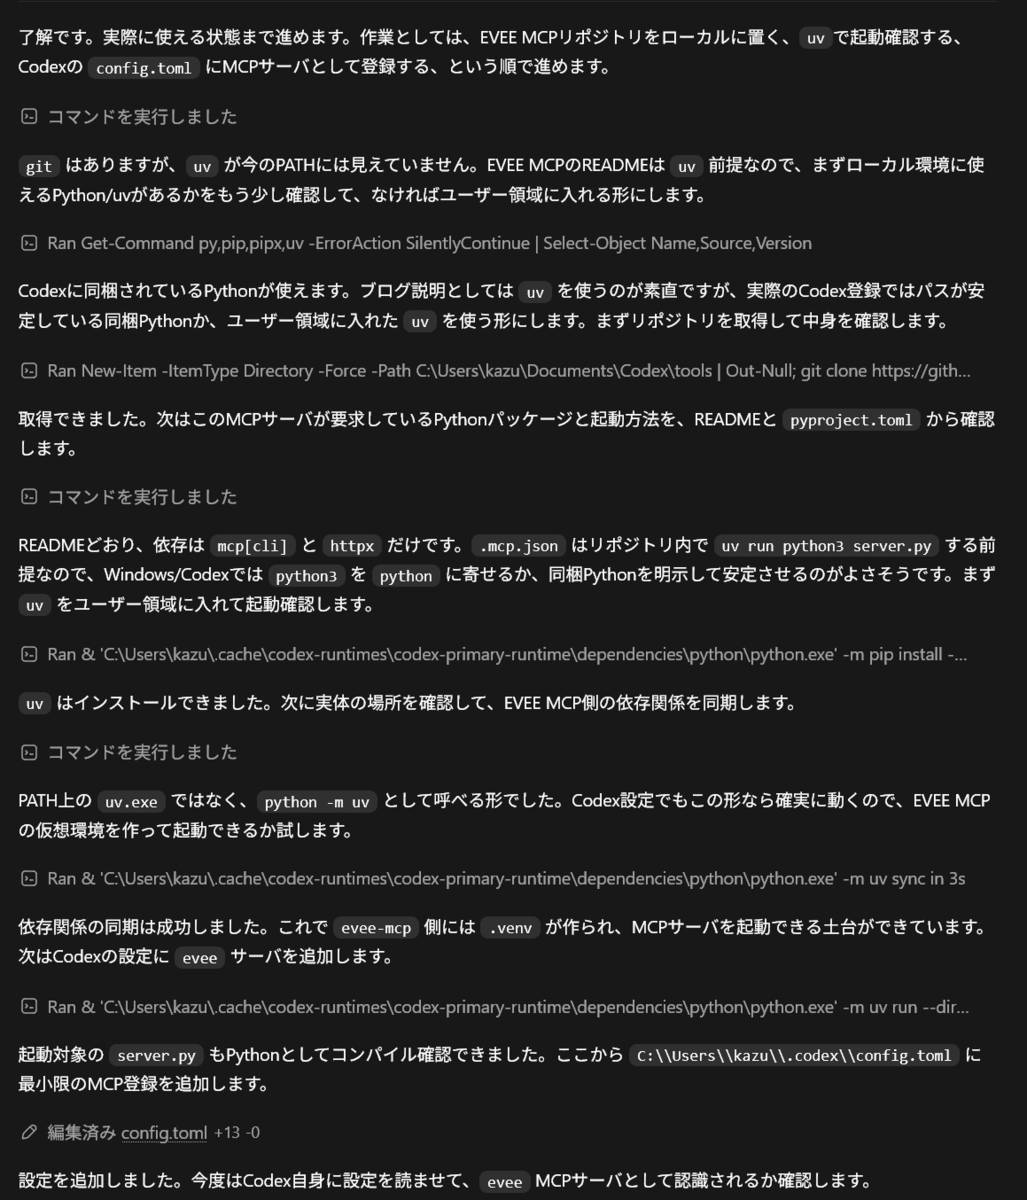
(codex 5.5 thinking "middle")
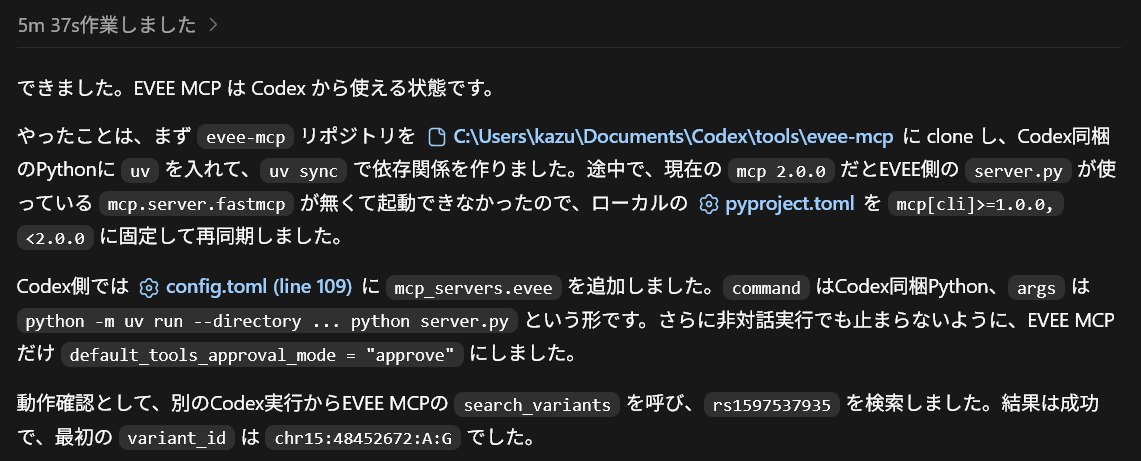
準備できたら別プロセスのCodexを起動して認識されているか確認する。/mcp
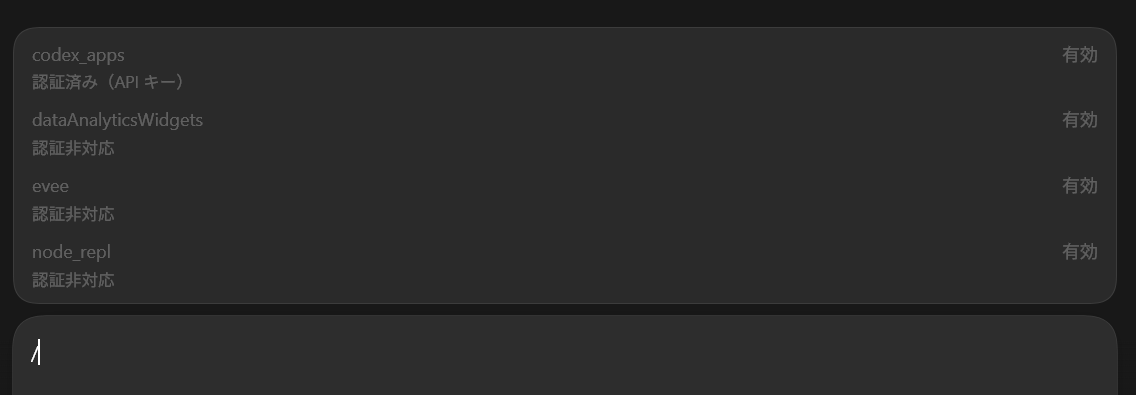
有効になっている。認証非対応はエラーではなく、このMCPサーバがAPIキーによるログインを必要としないことを示している。
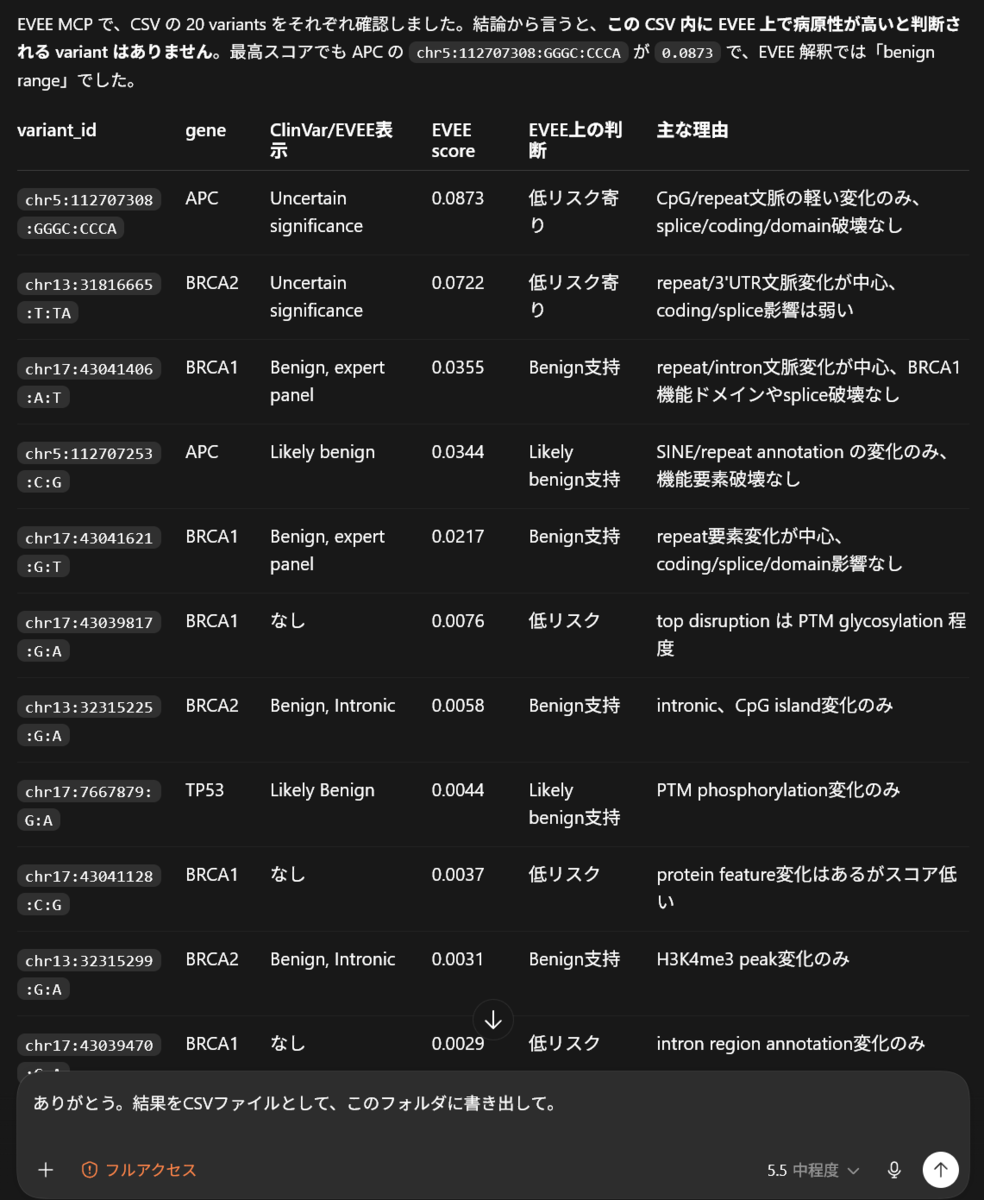
MCP名を指定して、自然言語で説明する。
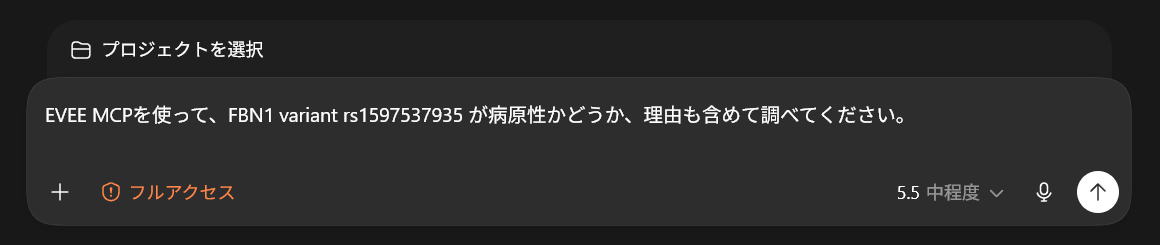
解答例
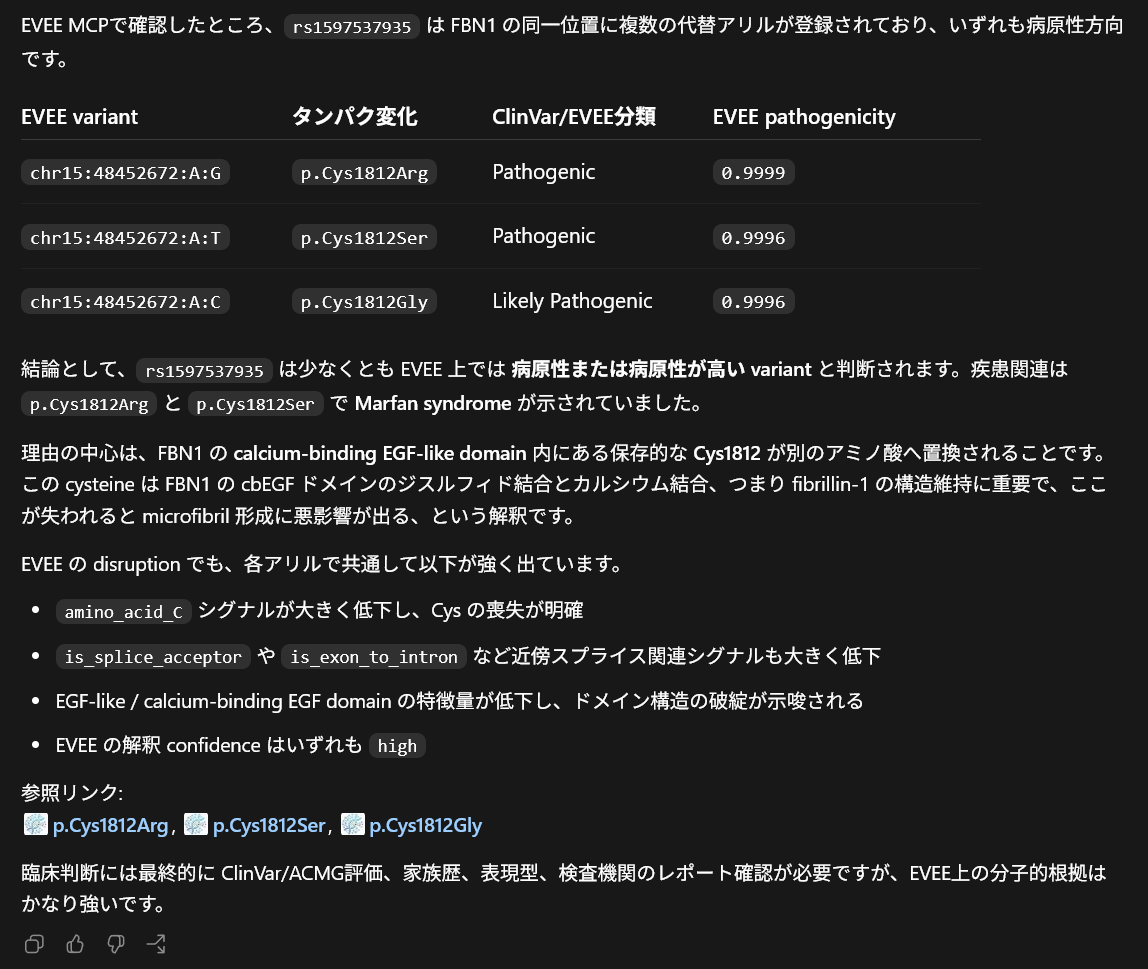
MCPでAIエージェント経由でアクセスした場合、EVEEの結果をcodexが使っている大規模言語モデルが解釈して、ユーザーに提示することになる。そのため、EVEEのWebサイトを人間が直接閲覧する場合と比べて、病原性と判断された根拠を自然言語でまとめて確認でき、結果をより直感的に理解しやすくなっている。
大規模言語モデルの性能によって結果は変化するが、上の画像の例では、大規模言語モデルは、各バリアントの病原性スコア、アミノ酸置換、影響を受けるドメインや生物学的特徴を整理して提示して、codexを使用している人間が結果を理解しやすいように工夫している様子がうかがえる。
さらに、AIエージェントを利用する利点として、使用上限に達しない限り、Codexとの対話を継続できる点が挙げられる。EVEEの結果について追加の質問をして最初の回答からさらに解析を掘り下げられる。特に興味深いバリアントが見つかった場合には、codexとの対話を継続し、Codexへ追加の指示を与えて別のMCPサーバーに対応した外部データベースへアクセスさせることもできる。これにより、タンパク質の立体構造、集団ごとのアレル頻度、患者の表現型など、EVEEだけでは十分に扱えない情報も横断的に自動で調査できる。、また、大規模言語モデルは、既存の論文から情報を集約するのも得意とする。AIエージェントを起点としてMCP対応webデータベースや文献情報を統合することで、EVEE単独の予測結果だけに依存せず、より多角的なバリアント解釈が可能になる。
もちろんバリアントリストのVCFファイルやTSVをファイルをドラッグしてもよい(リストが巨大すぎると時間がかかるので、主要な候補リストだけにする)。
出力例
論文より
- 生物学的配列データで学習された科学基盤モデルは、それらが表現対象とする生物学的システムについて、相当量の情報を内部に保持している[1, 2]。しかし、こうしたモデルを実用へとつなげるうえでは、依然として二つの問いが中心的な課題として残されている。すなわち、これらのモデルは何を学習したのか、そして、その知識を予測可能かつ解釈可能な形でどのように取り出せるのか、という問いである。この問いを、ゲノム変異の影響予測ほど直接的に試し、かつ重大な意味を持つ問題はほとんどない。
- DNAシーケンシングによって、解釈可能な数を上回る変異が日常的に検出されており[3, 4]、その大部分が「意義不明の変異(Variants of Uncertain Significance:VUS)」として曖昧なまま分類されている[5, 6]、これは現在もゲノム医療における主要なボトルネックとなっている。
- 変異影響予測法は、タンパク質言語モデル(EVE[7]、ESM2[1]、AlphaMissense[8])、教師ありの配列―機能モデル(Enformer[9]、Borzoi[10]、Nucleotide Transformer v3[11, 12]、AlphaGenome[13])、進化的DNAモデル(GPN-MSA[14]、Evo 2[2])、古典的なメタ予測法(CADD[15])など、数多く開発されてきた。それにもかかわらず、互いに関連する二つの限界が残されている。
- 第一に、これらの手法は対象とする生物学的領域ごとに分断されている。タンパク質に基づく手法は主としてミスセンス置換に限定され、配列―機能モデルは主に遺伝子調節への影響に焦点を当て、ゲノム全体を対象とするメタ予測法は、性質の異なる複数のエビデンスを単一のスコアへと圧縮する[13, 15, 16]。
- 第二に、大部分の手法は予測を提示するものの、その機序を示さない。臨床利用において、スコアだけで十分であることはほとんどない。変異の分類には、その変異がなぜ有害であるのかを示す、カテゴリー化されたエビデンスが必要であり、これはACMG/AMPガイドラインなどの枠組みにおいて明文化されている[6]。
- ただし、これらの限界は、必ずしも基盤モデルに本質的に備わったものではない。単一のゲノムワイドモデルは、コード配列と非コード配列の両方を一つの共有空間内で表現しており、異なる変異クラスを横断して予測を統合できる可能性を示している。課題は、こうしたシグナルをどのように読み出すかにある。変異の影響は一般に、モデルの出力尤度から推定される。すなわち、変異を導入した際に、モデルがその配列へ割り当てる確率がどの程度変化するかを用いる。この方法は強力である一方、数十億個のパラメータを持つネットワークの内部状態を、単一のスコアへと縮約してしまう。さらに、この方法には、すでにいくつかの失敗例が報告されている[2, 17]。
- これに対して、モデルの内部表現は、はるかに豊富な情報を含んでいる。内部表現は、ゲノム全体にわたる進化的制約を捉えるとともに、遺伝子構造や機能的なタンパク質要素など、解釈可能な生物学的特徴に沿って配列を体系化している[2, 12, 18]。そこで、これらの内部表現を体系的にプローブすることにより、尤度スコアリングを上回る予測能力と、単一のスカラー値を出力する予測法では得られない機序情報とを引き出せるかどうかを検討した。
- 本研究では、70億パラメータからなるゲノム基盤モデルEvo 2を構造化された方法でプローブすることによって、この問いに答えられることを示す。すなわち、Evo 2の内部表現から、正確であると同時に生物学的に解釈可能な変異影響予測を得ることができる。埋め込みは、全32ブロックにわたる層の網羅的調査(Supplementary Figure S1)に基づいて選定された第27層から抽出された。
- 大規模言語モデルを利用して、これらの具体的なシグナルを、各変異に固有のゲノム上の文脈と統合し、実験的に検証可能な機序仮説を生成することができる。
-
EVEEは、ClinVarに登録された多数のヒトバリアントについて、参照配列と変異配列をEvo2に入力し、その違いを比較したデータベースである。各バリアントについて、野生型に相当するリファレンス配列と、そこへ変異を導入した配列を用意し、ゲノム基盤モデルEvo2の70億パラメータモデルEvo 2-7Bを使い、変異導入前後に生じるEvo 2の内部表現や尤度の変化を事前計算している。つまり、変異によって配列がEvo2にとってどの程度不自然になったか、また内部の埋め込み表現がどの程度変化したかをもとに、病原性の可能性をスコア化している。
-
単に病原性スコアを提示するだけでなく、そのバリアントがどのような生物学的機能へ影響する可能性があるかも解析している。具体的には、スプライシング、タンパク質ドメイン、二次構造、調節領域、クロマチン状態などについて、参照配列と変異配列の予測結果の差を示している。これにより、各バリアントがなぜ有害と考えられるのかを、複数の生物学的観点から解釈できるようにしている。
- 病原性予測には、各変異部位の周囲から、上流側のコンテキスト49k bpと下流側の影響領域16k bpを合わせた、固定長65kbpのウィンドウが抽出して使用された。ウィンドウサイズを大きくするにつれて精度が向上した。ストレージ容量を抑えるため、各鎖について、65kbp全てではなく、リファレンス配列と変異配列の間で(コサイン類似度に基づき)最も差異が大きい256箇所の埋め込み表現のみを保持した(変異の影響が必ずしも変異塩基の位置だけに現れるとは限らないので、65kbpコンテキストで、参照配列と変異配列の埋め込みベクトルの変化が最も大きい256ポジションを選んだということ、選ばれる位置は連続している必要はなく、65 kbpの範囲内に離散的に分布していてもよい)。
- EVEEは、ClinVarに登録された全420万件のバリアントについて病原性の予測を行っている。この分類器は、多様なバリアントの影響タイプにわたり最先端の性能を達成し(ClinVarの83万9000件のバリアントにおいて全体AUROC 0.997)、Indel(挿入・欠失)に対してもゼロショットで高い汎用性を示した(AUROC 0.991)。
- 各バリアントの遺伝子情報、病原性スコア、アノテーションプローブの変化などを統合し、想定される分子機序を文章化するために、大規模言語モデルも使用されている。解釈は、3つのClaudeモデル(Haiku 4.5、Sonnet 4.6、Opus 4.6 [37])によって生成されている。各解釈は、2つの独立したLLM判定者(Claude Opus 4.6、表S3)により、3つの軸に沿って1~5の尺度で評価された。
-
リファレンス配列と変異配列は、いずれもセンス方向とアンチセンス方向の両方から取得され、indelについては、リファレンス配列と変異配列をアラインメントし、対応しない位置は除外された。埋め込み表現の抽出には、約20,000 H100時間の計算資源を使用した(H100を20000時間)。得られたデータセットの形状は、4,252,870 × 2 × 512 × 4,096(バリアント数 × 変異配列/リファレンス配列 × 位置数 × 次元数)であり、bf16形式で保存した場合のデータ容量は約34TBとなった。
- EVEEは単にEvo2を利用してバリアントの有害性スコアを算出するだけでなく、参照配列と変異配列における内部表現の差を解析し、その変異がスプライシング、タンパク質ドメインや二次構造、遺伝子調節領域、クロマチン状態などに、どのような影響を与える可能性があるかも予測する。さらに、これらの変化を既知の生物学的アノテーションと対応づけることで、そのバリアントがなぜ有害と判断されたのかを多角的に解釈できるようにしている。
- ClinVarの420万件のバリアントに関する、病原性予測および機能阻害プロファイルの事前計算データは、EVEEウェブアプリケーションおよびZenodoの一括データセットから利用できる。さらにEVEE MCPサーバー(https://github.com/goodfire-ai/evee-mcp)によるプログラムによるアクセスを提供し、LLMを用いた解釈ができるようにしている。
コメント
EVEEの使用例を通じて、MCP対応サーバーの強みが自分なりに理解できた気がします。今後、ますますMCP対応サーバーやMCP対応ローカルアプリは増えそうですね (注: MCPに対応していないWebサイトであっても、ブラウザ操作機能を持つAIエージェントであればアクセスできる。ただし、これはAPIを介したアクセスではなく、人間と同じようにページを開いて、リンクやボタンを仮想カーソルを使って操作するので、MCPやAPI経由のアクセスと比べると処理が非常に遅く、画面構成の変更や読み込みの失敗などによるエラーも頻繁に起こし、途中で諦めることもある)。
また、MCPはAIエージェントから利用できる外部ツールを追加する仕組みですが、codexにMCPを入れすぎると、どのツールを使うべきかの判断が曖昧になって意図しないない外部ツールが使われる可能性もあるので注意してください(MCPの追加は慎重に行なう)。
引用
Interpretable variant effect prediction from genomic foundation model representations
Michael T. Pearce, Thomas Dooms, Ryo Yamamoto, Shant Ayanian, Alexander J. Ryu, Joshua Meehl, Carl Molnar, Tuomo Kiiskinen, Mark Bissell, Dron Hazra, Ching Fang, Nam Nguyen, Michael Anderson, Collin Osborne, Patrick Duffy, Bridget Toomey, Elena Myasoedova, Eric Klee, Panos Korfiatis, Matt Redlon, Archa Jain, Daniel Balsam, Nicholas K. Wang.
bioRxiv. 2026. doi:10.64898/2026.04.10.717844.
関連
- Rustで記述された高性能なバリアント効果予測ツール fastVEP
-
大規模な遺伝子バリアントアノテーションのための統合的かつ対話的なプラットフォーム Annotation Query (AnnoQ)
-
(ヒト)遺伝子スクリーニングの結果をタンパク質の配列と構造にリンクする Genomics 2 Proteins portal
-
(ヒト向け)8つの異なるバリアントコーラーとデータベースを組み合わせてフィルタリングし、アーティファクトを除きながら高感度なバリアントコールを行う自動パイプライン appreci8
参考
MCP
MCP(Model Context Protocol)は、LLMが外部のデータベースや解析サービスを「tool」として発見し、必要な引数を渡して実行し、構造化された結果を受け取るための共通規格である。従来のAPIでもプログラムからデータベースを利用できるが、サービスごとに入力形式、認証、ページングおよびエラー処理が異なり、LLMが自律的に組み合わせて使用するには個別の実装が必要であった。
MCPでは各操作について、入力・出力をJSON Schemaで記述し、その操作が何を意味するかを科学的概念やメタデータと関連付ける。論文では、MCPを既存APIの代替ではなく、APIの上に追加するLLM向けの共通レイヤーとして位置付けている。
