DBCLSが維持管理するRDF Portalの知識グラフは、約60の生命科学データベースを統合しているが、これを検索するにはSPARQLと各データベース固有のRDFスキーマの両方に精通している必要があり、そのため大多数の研究者にとって利用が困難なリソースとなっている。大規模言語モデル(LLM)は、原理的には自然言語による質問を実行可能なSPARQLへ変換できるが、スキーマレベルの文脈が与えられていない場合、存在しない述語を頻繁に捏造したり、エンティティ名をデータベース固有の識別子へ対応付けられなかったりする。本研究では、LLMを、Model Context Protocol(MCP)を介して専門的なツール群を統括するプロトコル駆動型推論エンジンとして再構成したシステム、TogoMCPを提示する。その設計には2つの仕組みが不可欠である。1つ目は、各ターゲットデータベースの構造的および意味的な文脈を、クエリ実行時にLLMへ動的に提供する簡潔なYAML文書であるMIE(Metadata-Interoperability-Exchange)ファイルであり、2つ目は、外部REST APIを用いたエンティティ解決と、スキーマに基づくSPARQL生成とを分離した2段階のワークフローである。
5種類の質問形式と23のデータベースにまたがる、生物学的根拠を持つ50問のベンチマークにおいて、TogoMCPは支援なしのベースラインと比較して大幅な性能向上を達成し(Cohenの[統計量欠落]、Wilcoxon[統計量欠落])、特に明確かつ検証可能な回答を持つ質問形式では勝率が80%を超えた。アブレーション解析では、すべての構成要素の組み合わせが有意な改善をもたらすことが示され、そのなかでもMIEスキーマファイルは、質問ごとの平均スコアに対して最大の限界的寄与を示した。MIEを使用しない条件と比較した改善量は[数値欠落]であり、両側Wilcoxon検定では[統計量欠落]、90%ブートストラップ信頼区間[数値欠落]はゼロを含まなかった。関連するMIEファイルを読み込むよう指示する1行の命令だけでも、完全な手順プロトコルと同等の平均的な改善が得られた一方で、完全なプロトコルには性能低下のリスクをさらに抑える効果があり、損失率は完全なプロトコルで1.6%、1行の指示で4.8%であった(Fisher[統計量欠落])。
これらの結果は、平均スコアの性能を向上させるうえでは、複雑なオーケストレーションロジックよりも、簡潔で動的に提供されるスキーマ文脈の方が価値が高く、一方で手順に関するガイダンスは性能のばらつきを小さくするという補完的な役割を果たす、という一般的な設計原則を示唆している。
HP
TogoMCP – Model Context Protocol Server for Life Sciences
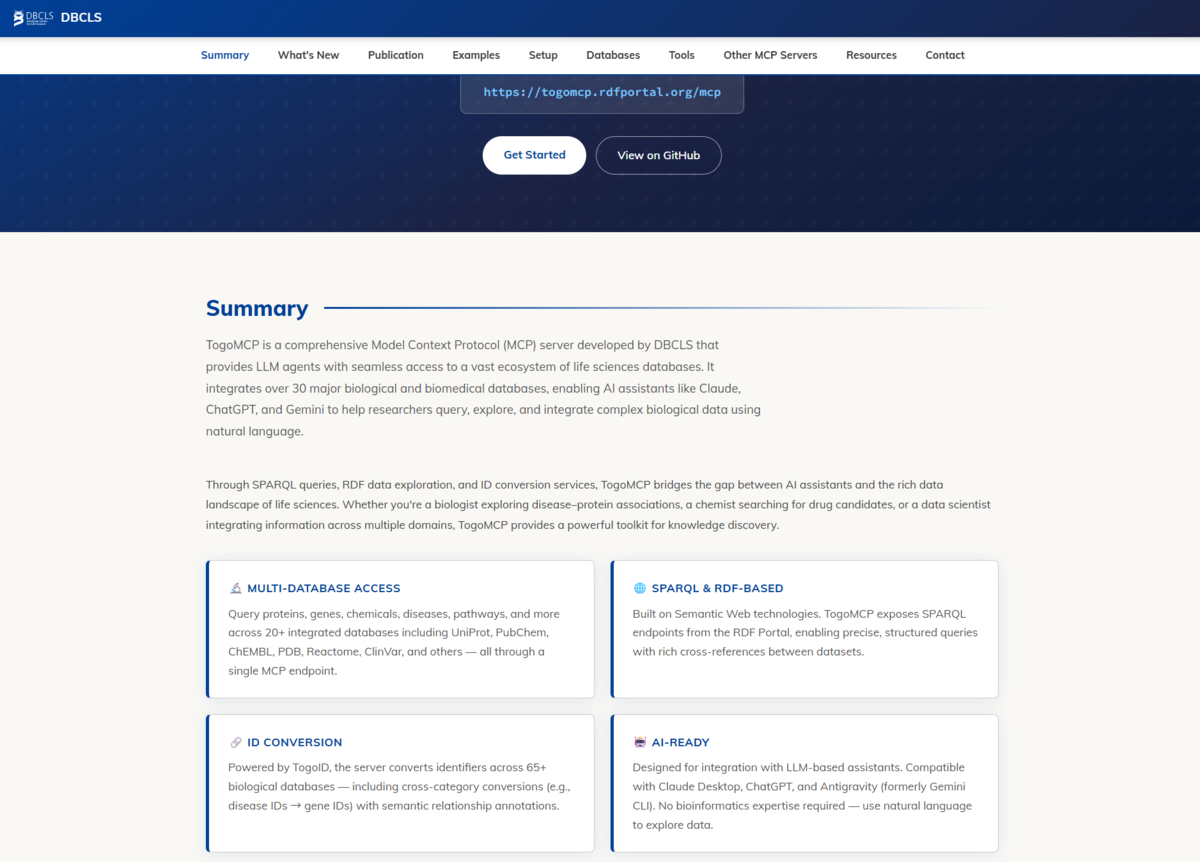
Setup Guideが用意されている。
インストール
公開されているTogoMCPの統合サーバーを利用し、Codexから試した。
Github
TogoMCPは、公開サーバーを利用する方法と、自分のPCでサーバーを動かす方法の2通りがある。公開サーバーを利用する場合、Pythonやuvをインストールする必要はなくて、cladeやcodexなどのAIエージェントツールの設定ファイルに、URLを登録するだけで利用できる(下で説明)。ただし、KEGG関連のツールは、ライセンス上の理由から公開サーバーでは提供されておらず、利用するにはローカル版と追加設定が必要。
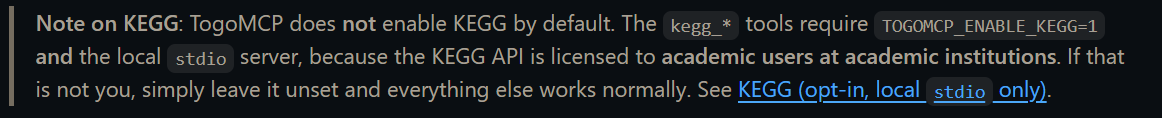
(レポジトリより)
ここではcodexで試す。設定=>構成、右上のconfig.tomlで開くを選択、
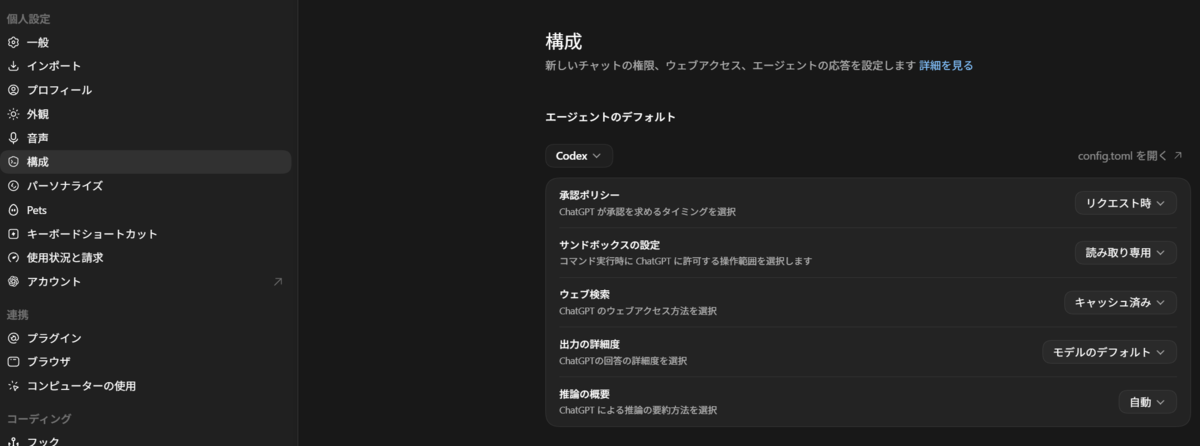
defaultのエディタが開くので、以下2行を記載して閉じる。
[mcp_servers.togomcp]
url = "https://togomcp.rdfportal.org/mcp"
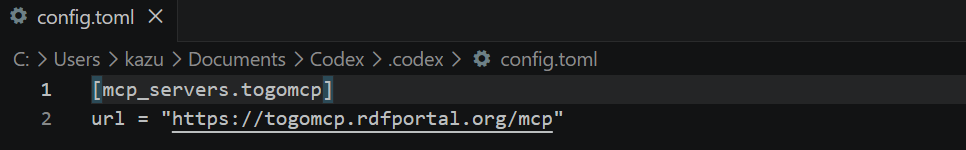
codexを再起動すると認識する (codexがバックグラウンドで動いている場合、タスクマネージャーから終了させる)。
/MCPとタイプ
togomcpと出ている。
テストラン
レポジトリに書かれている例を試してみる。
最初にTogoMCPを使うことを宣言しておく。
"このチャットでは、TogoMCPを使って作業します。"
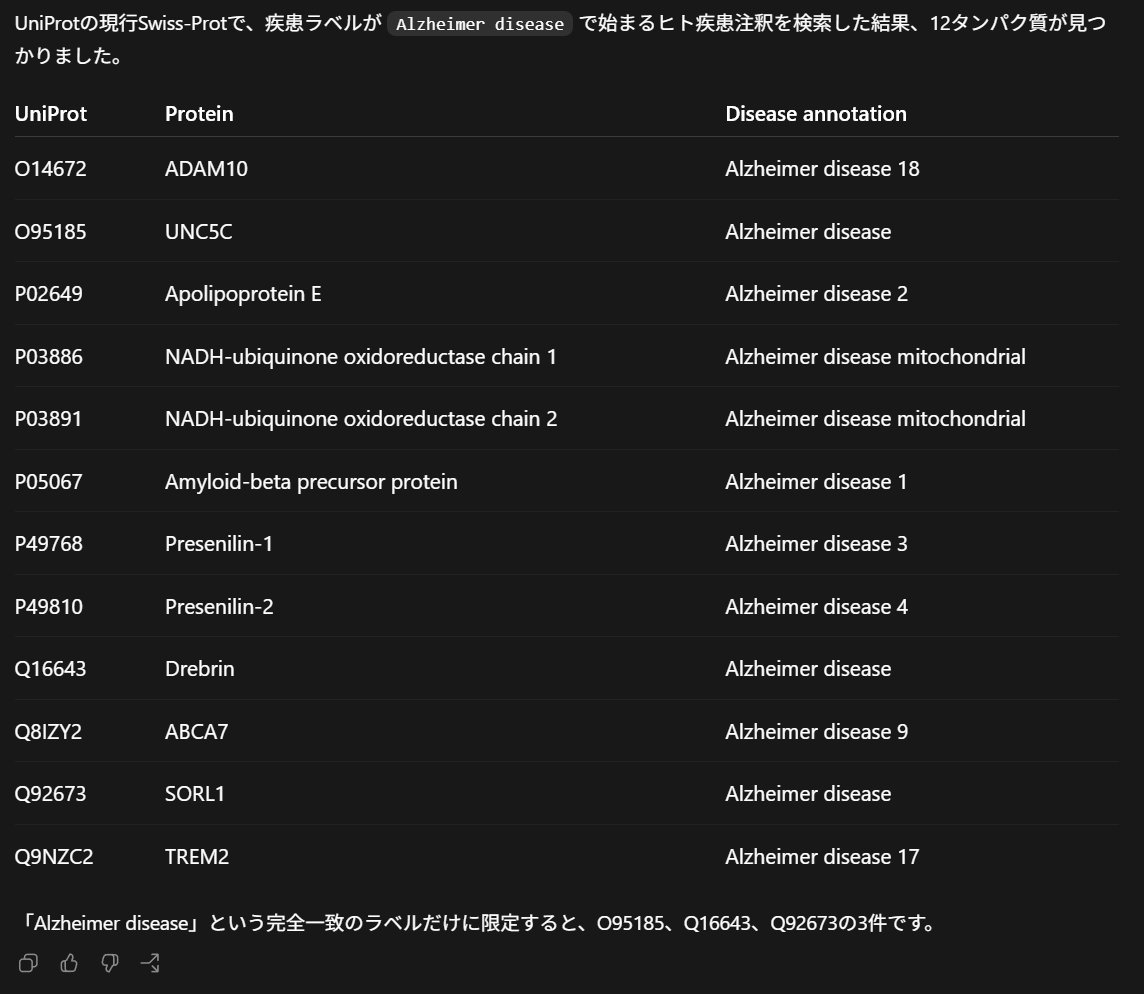
自然言語で指示を出す。ここではAlzheimer diseaseで始まる疾患注釈を、Uniprotに限定してサーチする。
1、"Find all human proteins associated with Alzheimer's disease in UniProt."
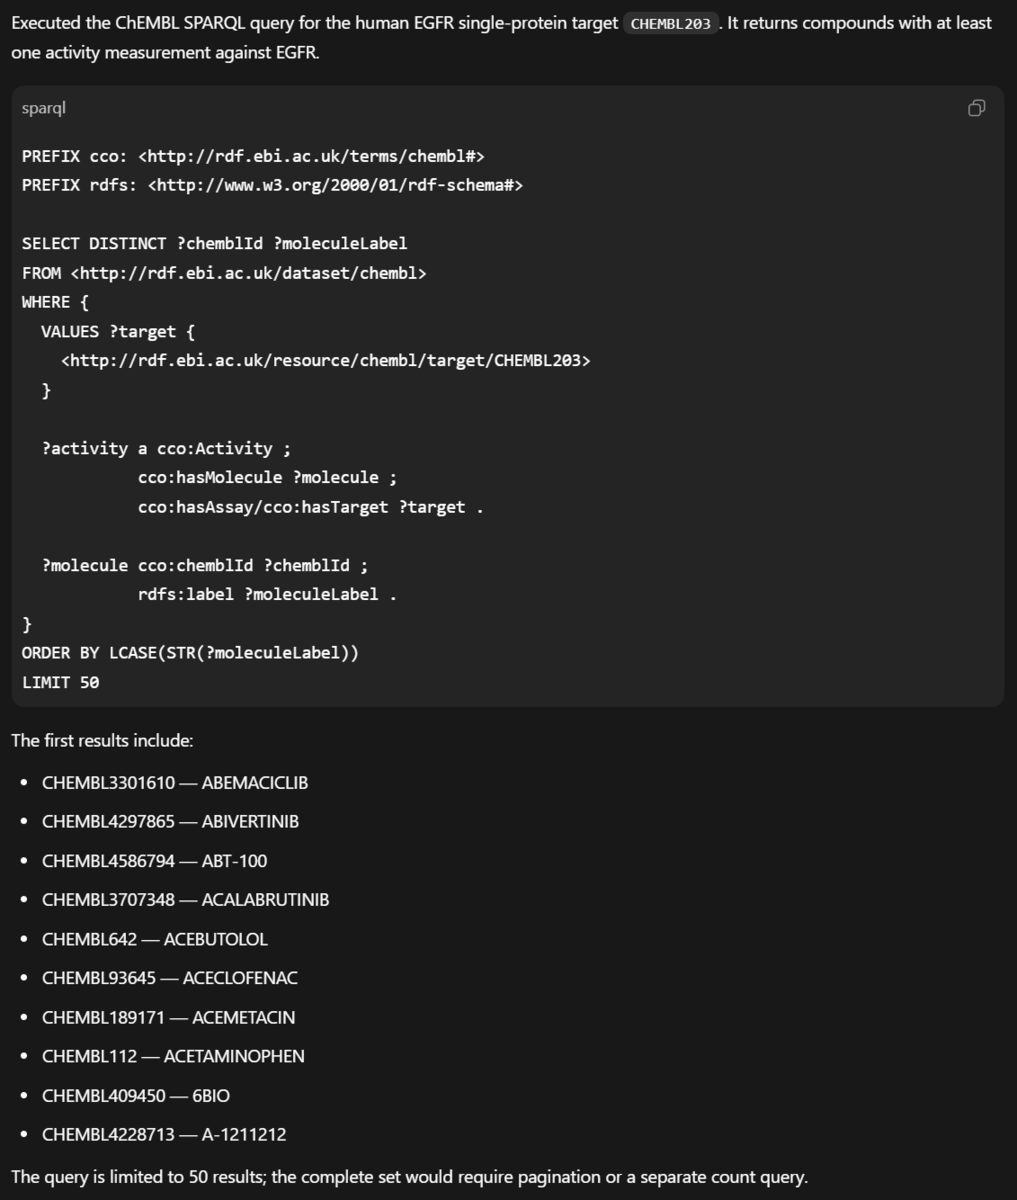
2、"Run a SPARQL query on the ChEMBL database to find compounds targeting EGFR."
次はPubmedの例。 Pubmedがカバーしている論文を横断的に検索する (別途Pubmed mcpを使わなくても良いので楽)。
3、"Search PubMed for recent papers on CRISPR base editing."
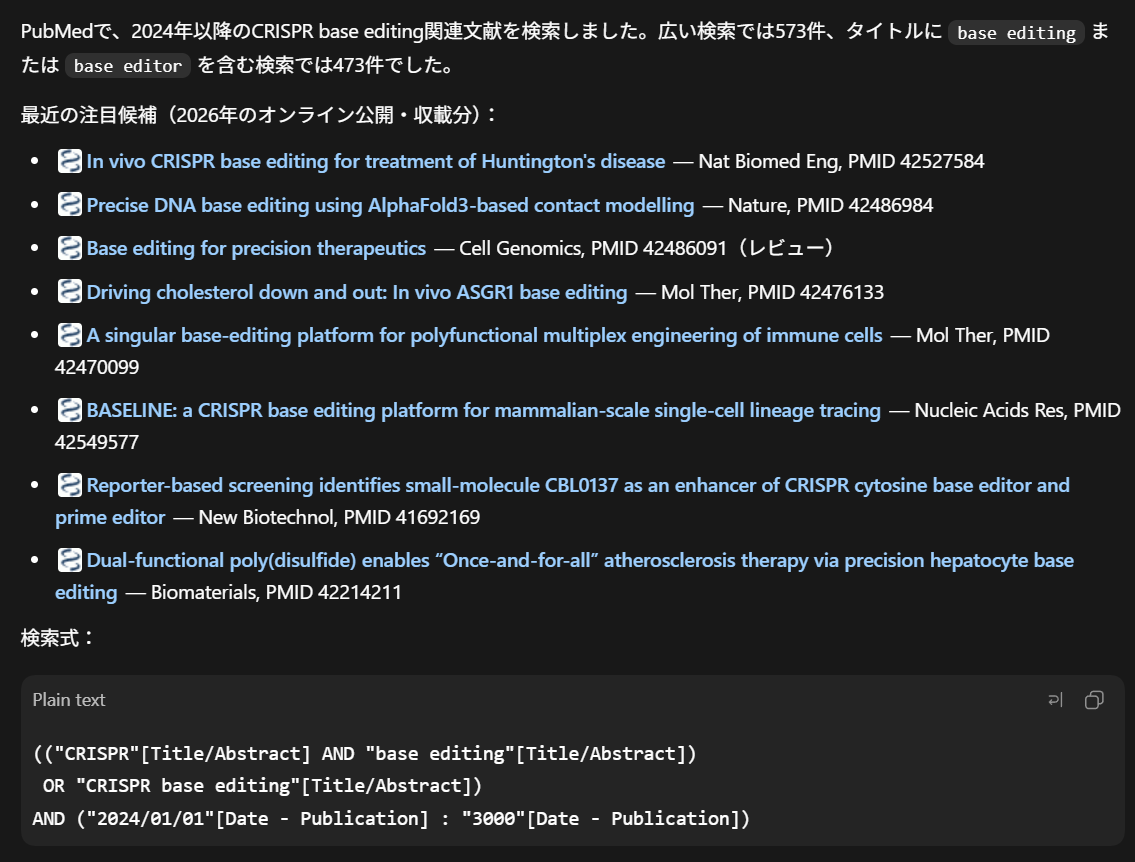
リンク先はPubedとなっている。
Reactomeに限定してパスウェイをサーチする。
4、"What pathways involve the TP53 gene in Reactome?"
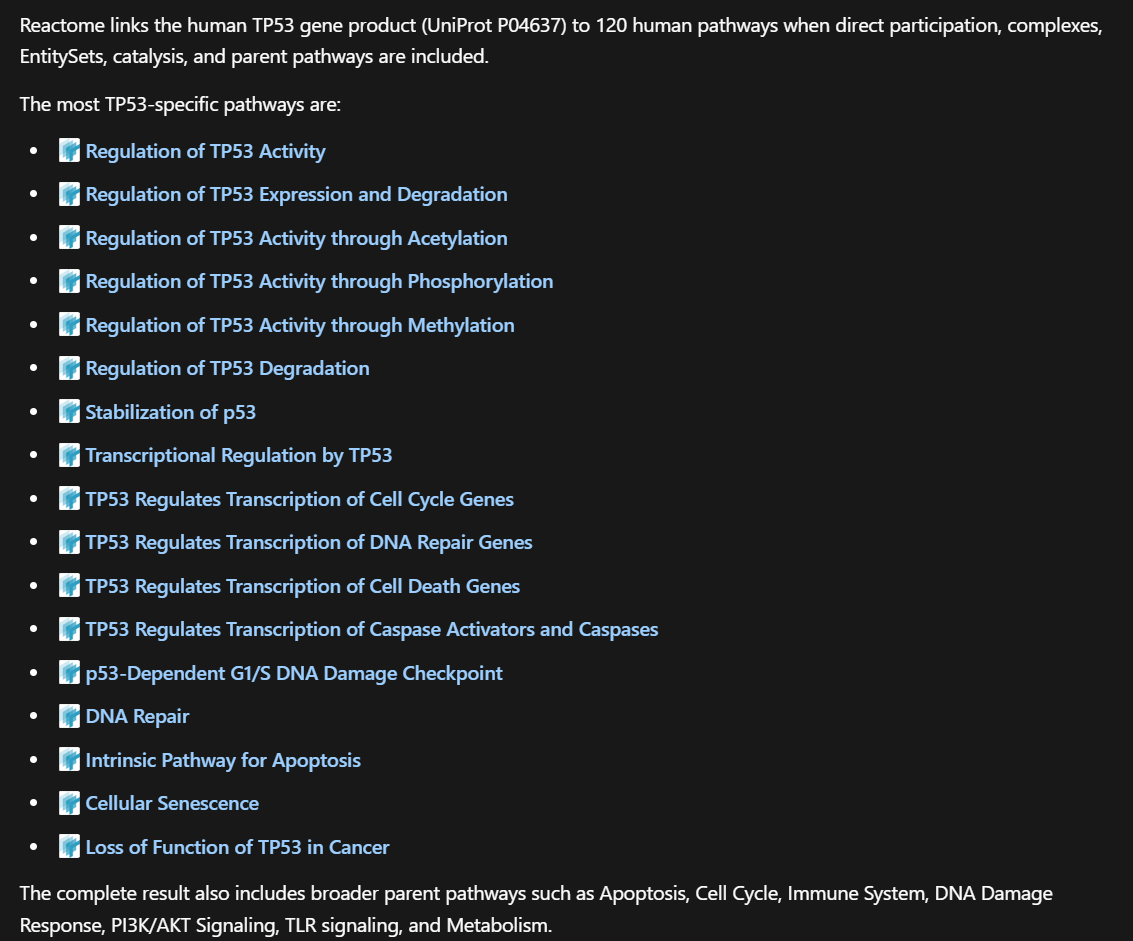
リンク先はReactomeとなっている。
TogoMCPが利用可能なデータベース/ツール
レポジトリによると、以下の知識データベースに対応している。
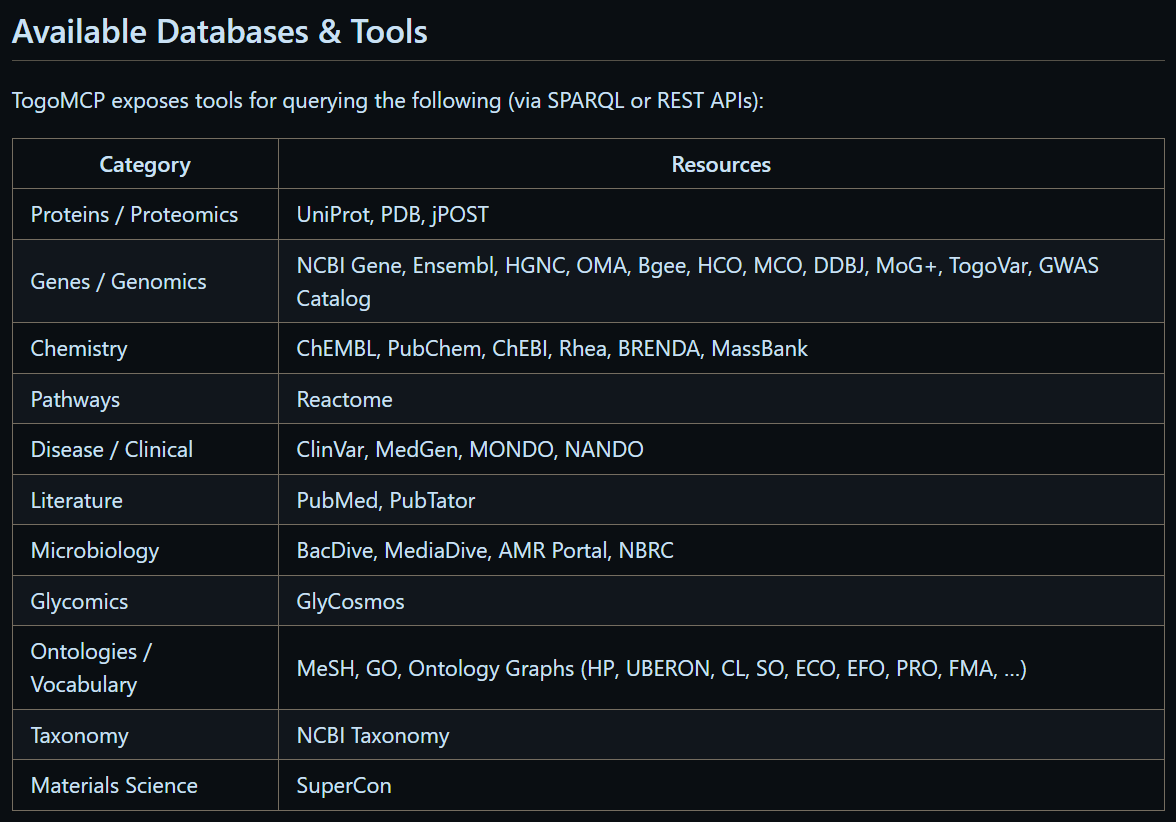
TogoMCPは代表的な遺伝子・タンパク質DBに加えて、疾患や臨床、化合物や酵素反応のDBを広範囲にカバーしている。文献、糖鎖、オントロジーなどの語彙、分類学的分類、微生物関連のDBも含まれている。また、遺伝子のID変換や遺伝子IDとタンパク質IDの対応付け(ID mapping)、GWASと臨床バリアント、疾患情報の関連付け、病原性細菌の抗菌薬耐性や代謝系の横断的な調査、微生物の分類や代謝系の整理など、生命科学の研究者がルーティンで行う可能性のある作業を主要にカバーしている。
その他、気づいた点
- レポジトリでは、TogoMCPを自分でサーバーで立ち上げる手順と、Dockerコンテナでの運用方法やログ設定の方法が説明されている。その場合、Codexの接続先は公開URLでなく自分のサーバーURLになる。
- TogoMCPの特徴として、これらのデータベースを個別に検索できるだけでなく、自然言語や検索API、SPARQLを組み合わせ、複数のデータベースをまたいだ探索を行える点が挙げられる。
- MCPでは複数のサーバーを横断して検索できるため、どのサーバーを使用し、どのような方法で情報を取得したのかを、検索結果と併せて保存しておくことが重要。特に、AIエージェントに自然言語で検索を依頼した場合には、使用したサーバー、検索条件、実行方法、取得日時などを記録して、結果の再現性や追跡可能性を確保する。(例:「検索に使用したサーバーと手順をMarkdown形式で記録し、検索結果のテキストと同じフォルダに保存して」"。
- TogoMCPの現在のツール一覧には、BLASTのような配列類似性検索機能は含まれていない。TogoMCPは、配列そのものを比較するためのツールというよりも、生命科学データベースを横断的に検索して情報を集約することを目的としている。
そのため、CodexなどでTogoMCPを利用する際、対応していない指示を入力すると、別のツールや機能が自動的に使用される可能性があるので注意する (実行されたツール名、接続先のデータベースなどを記録しておく)。
引用
TogoMCP: natural language querying of life-science knowledge graphs via schema-guided LLMs and the Model Context Protocol
Akira R Kinjo , Yasunori Yamamoto , Samuel Bustamante-Larriet , Jose-Emilio Labra-Gayo , Takatomo Fujisawa
Database, Volume 2026, 2026, Published: 24 July 2026
関連
参考
