細菌は真核生物の宿主と密接に共生する適応能力を幅広く持ち、宿主の成長や健康に有害、中立、あるいは有益な影響を与える。しかし、ニッチ適応に関与する遺伝子のほとんどは未知であり、その機能も十分に明らかにされていない。ここでは、ゲノムアノテーション、大規模比較ゲノム解析、ライフスタイル関連遺伝子(LAGs)予測のための合理的な計算ワークフローであるbacLIFE(https://github.com/Carrion-lab/bacLIFE)を紹介する。その結果、植物病原性ライフスタイルに関連する可能性のある数百の遺伝子が同定された。これらの予測された機能未知のLAGのうち14個について部位特異的変異誘発を行い、その後植物バイオアッセイを行った結果、6個の予測されたLAGがBurkholderia plantariiとPseudomonas syringae pv. phaseolicolaの植物病原性ライフスタイルに実際に関与していることが示された。これらの6つのLAGには、糖転移酵素、細胞外結合タンパク質、ホモセリンデヒドロゲナーゼ、仮説的タンパク質が含まれていた。これらの結果を総合すると、bacLIFEはLAGを予測し、細菌と宿主の相互作用をより深く理解するための仮説を生み出すための効果的な計算ツールである。
wiki
https://github.com/Carrion-lab/bacLIFE/wiki/bacLIFE-wiki
bacLIFEは、細菌ゲノムから遺伝子クラスターと生合成遺伝子クラスター(BGC)を解析し、生活様式と関連する候補遺伝子を探索する。細菌が植物病原性、共生性、環境適応などの生活様式を示す理由を遺伝子の有無から調べたい場合に使うことができる。
インストール
win11のWSLで環境を作ってテストした(CPU: 9900X)。
Github
git clone https://github.com/Carrion-lab/bacLIFE.git bacLIFE
cd bacLIFE/
mamba env create -f ENVS/bacLIFE_download.yml
mamba env create -f ENVS/bacLIFE_environment.yml
mamba env create -f ENVS/antismash.yml
mamba env create -f ENVS/bigscape.yml

#baktaだけ入らなかったので別に入れる
conda activate bacLIFE_environment
mamba install -c conda-forge -c bioconda bakta -y
conda deactivate
依存関係が多く、インストールにはかなりの時間がかかる。日本時間の正午ごろに実行したところ、3時間ほどかかった(CPU: 9900X, win11 WSL環境)。
データべース
antiSMASH用データベースとbacLIFE依存データベースを取得する。
#1 antiSMASH
conda activate antismash_bacLIFE
download-antismash-databases
conda deactivate

#2 bacLIFE DB(Pafam-AのHMM,eggNOG DB, bakta, DBcan, phylophlan、BiG-SCAPE / MIBiG関連DBなど)
conda activate bacLIFE_environment
python src/download_dependencies.py
実行方法
注意: 実際に試したところ、snakemake周りで複数のエラーが出ました。snakemakeは新しいバージョンではなく、古いバージョンを入れて実行してください*1。また、BaktaについてもバージョンによってコマンドやDB形式の互換性でエラーが出やすいです。特に、古いBaktaで作成したDBを新しいBaktaで読むと失敗する場合があります。当時試した時も多くのエラーが出たので紹介を保留していましたが、公開から2年ほど経ってむしろ依存関係の互換性が厳しくなったようです。下の手順通りに進めても動かない可能性があります。時間がある時に、エラーを確認しながらじっくり進める必要があります。ご注意ください。
入力はFASTA形式の細菌ゲノムアセンブリで、data/ディレクトリに置く。Wikiでは、ファイル名は "Genus_species_strain_O.fna" 形式にする必要があると説明されている。wikiでは、 esearchを使って論文で使われたゲノムをダウンロードしてリネームするところから解説されている。自分のデータを使う場合、サンプルデータを消してから、bacLIFE/data/に配置する。
ここではVibrio natriegensを使う。NCBIからncbi_dataset.tsvとしてダウンロードする。

ncbi_dataset.tsvからcutコマンドなどでアクセッション列だけ抽出して、ここではNCBI_accs.txtテキストとして保存する。
1、ゲノムの準備
bitコマンドでゲノムをダウンロードして解凍する。
conda activate bacLIFE_download
cd download/
mkdir -p genomes
cd genomes
bit-dl-ncbi-assemblies -w ../NCBI_accs.txt -f fasta -j 10
#解凍
gzip -d ./*.gz
genomes/

2、NCBIから落としたゲノムFASTAをbacLIFE用に整理する。メタデータの取得と冗長性除去
cd ..
python main_script_download.py
NCBIメタデータが取得され、FASTAファイル名はbacLIFE用にリネームされる。さらにMashを使って99% ANIで冗長なゲノムを除く処理が行われる。残ったゲノムはgenomes_renamed/に置かれMETADATA_MERGED.txtが作られる。
> head METADATA_MERGED.txt

3、download/genomes_renamed/のFASTAをbacLIFE/data/に移し、bacLIFE用にゲノム名をさらに整理する。
cd bacLIFE
mv download/genomes_renamed/* data/

#bacLIFE用にゲノム名をさらに整理
conda activate bacLIFE_environment
Rscript src/rename_genomes.R data/ names_equivalence.txt

data/内の14ゲノムがbacLIFE用にリネームされ、names_equivalence.txtが作成された
> cat names_equivalence.txt

4、実行する。*1
#bacLIFE用にゲノム名をさらに整理
conda activate bacLIFE_environment
snakemake -j 8 --use-conda 2>&1 | tee -a bacLIFE_run.log
出力例
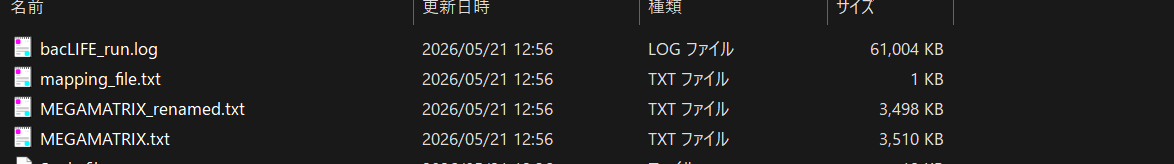
MEGAMATRIX_renamed.txtが最終的な結果。(MEGAMATRIX.txtはリネーム前のファイル)
mapping_file.txtはShiny app用のファイル。
MEGAMATRIX_renamed.txtを見てみる。
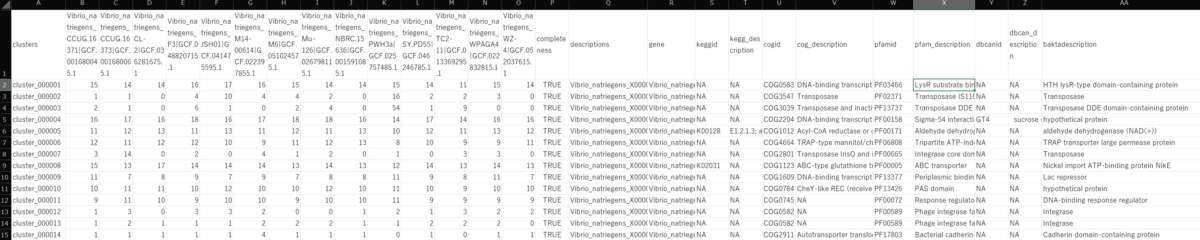
行は遺伝子クラスターを表す。各遺伝子クラスターごとに、対象とした株における存在の有無、さらにKEGG/COG/Pfam/dbCAN/Bakta/BiG-SCAPE情報などが示されている。
#Shinyで結果を分析できる。
Rscript -e "shiny::runApp('.', host='0.0.0.0', port=3838)"
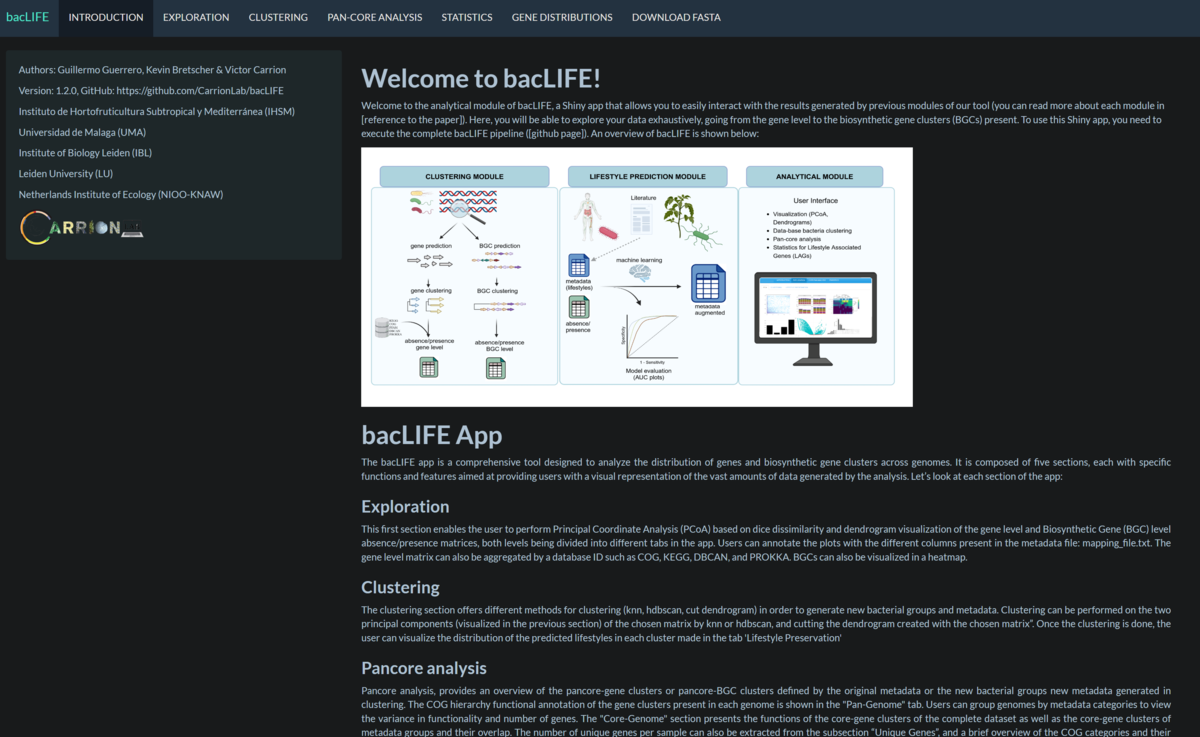
注: 画面が暗いのはダークモードで閲覧しているため
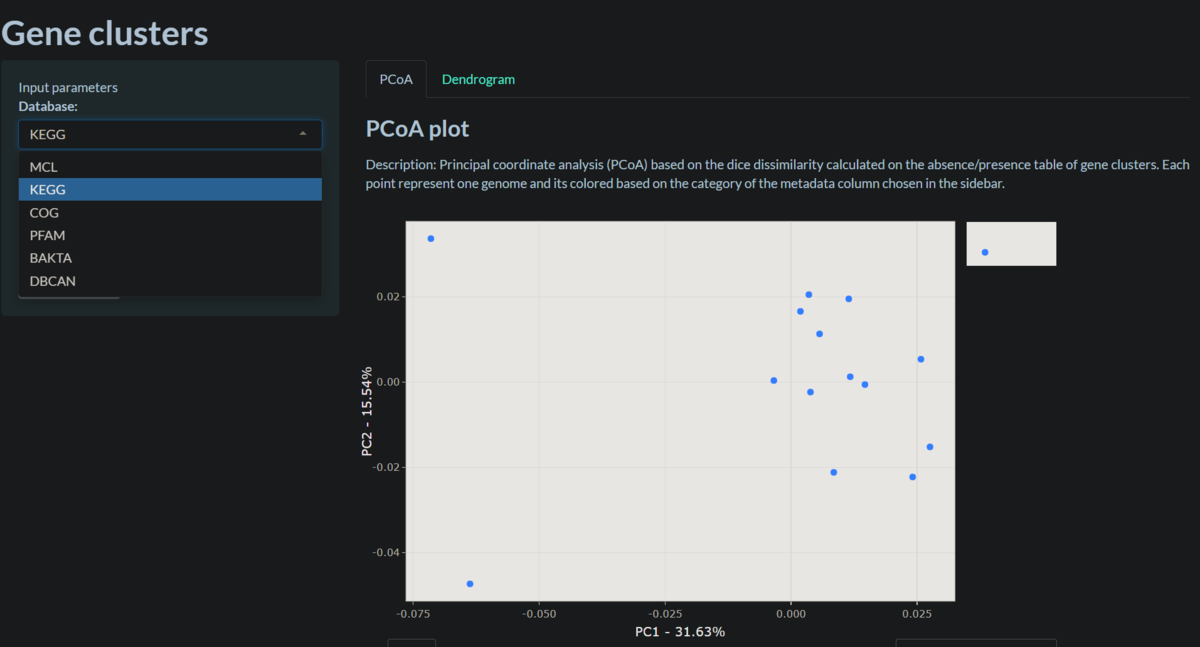
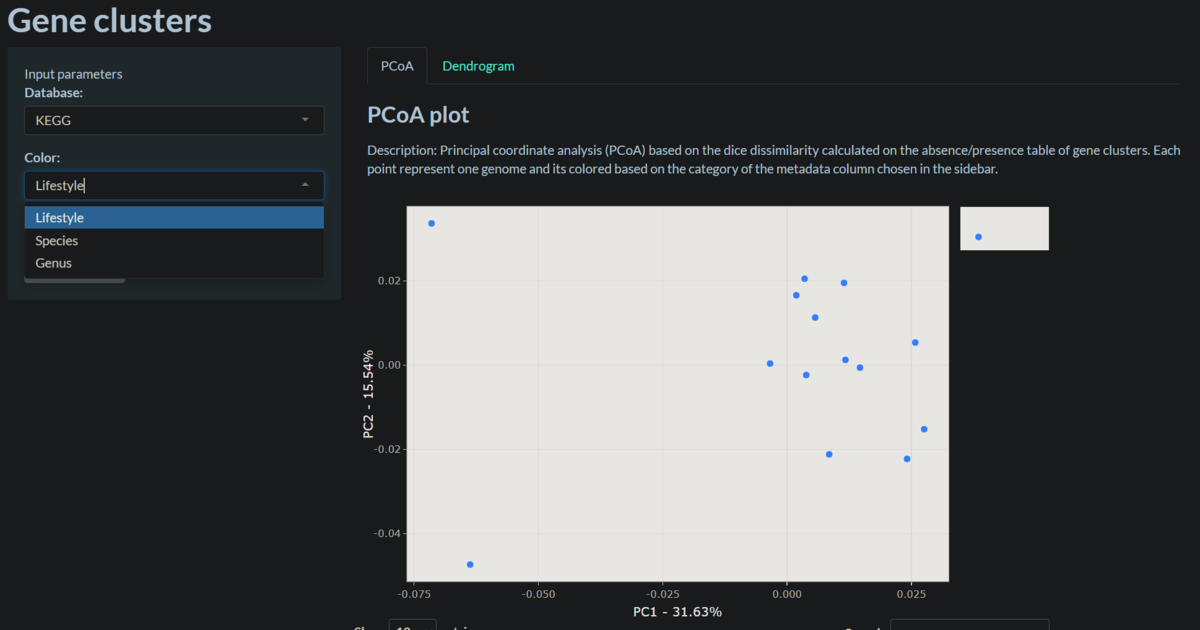
PCA plot
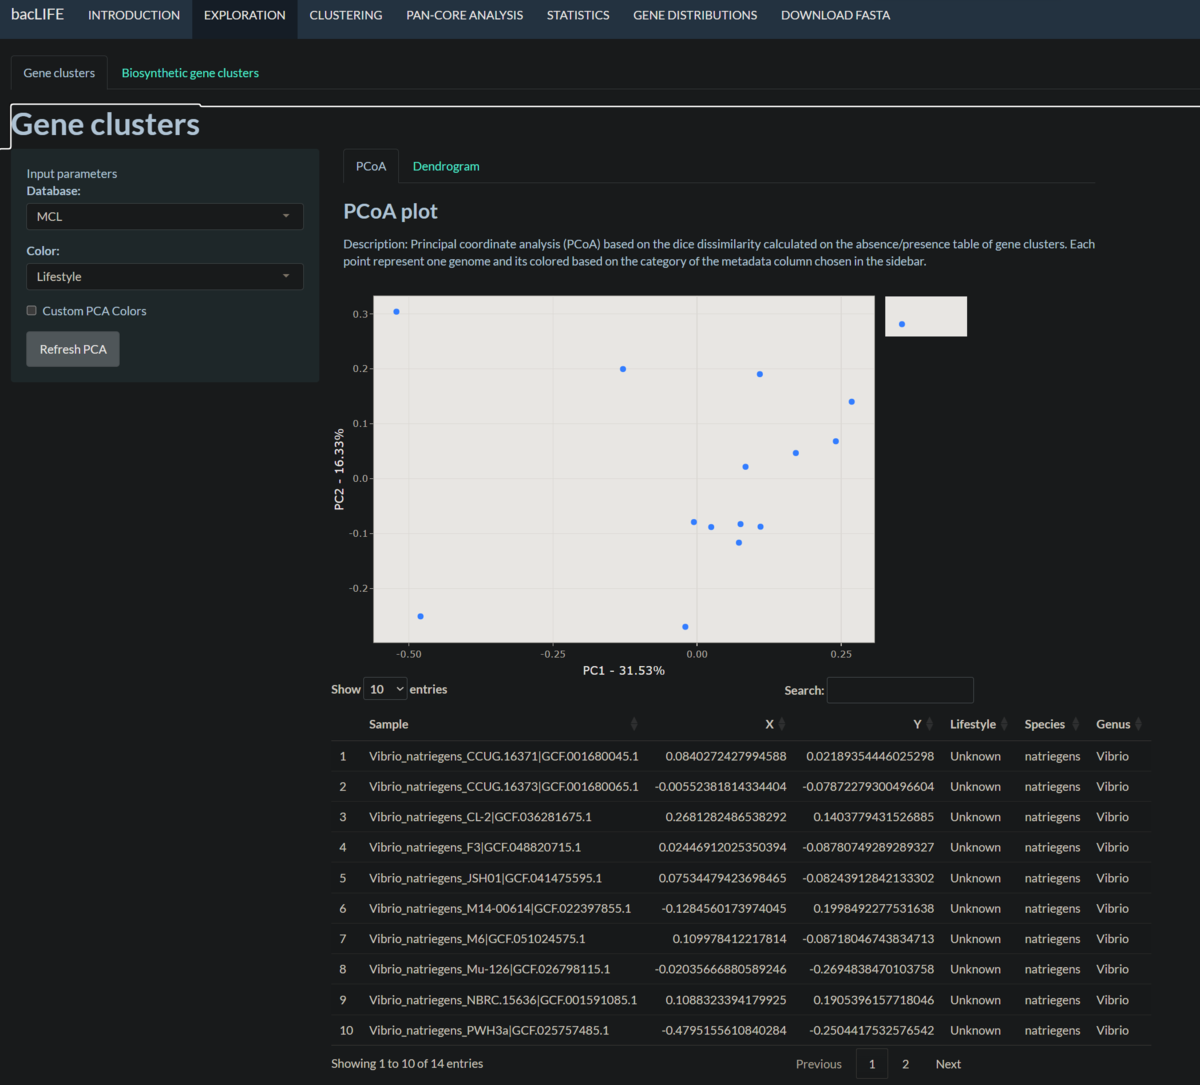
DBをKEGGに切り替え
色のアサインぱたーんを変更できる。種によって異なる色ならSpecies。Lifestyleは、各株の生活様式を示すメタデータ。設定していないと利用付加。
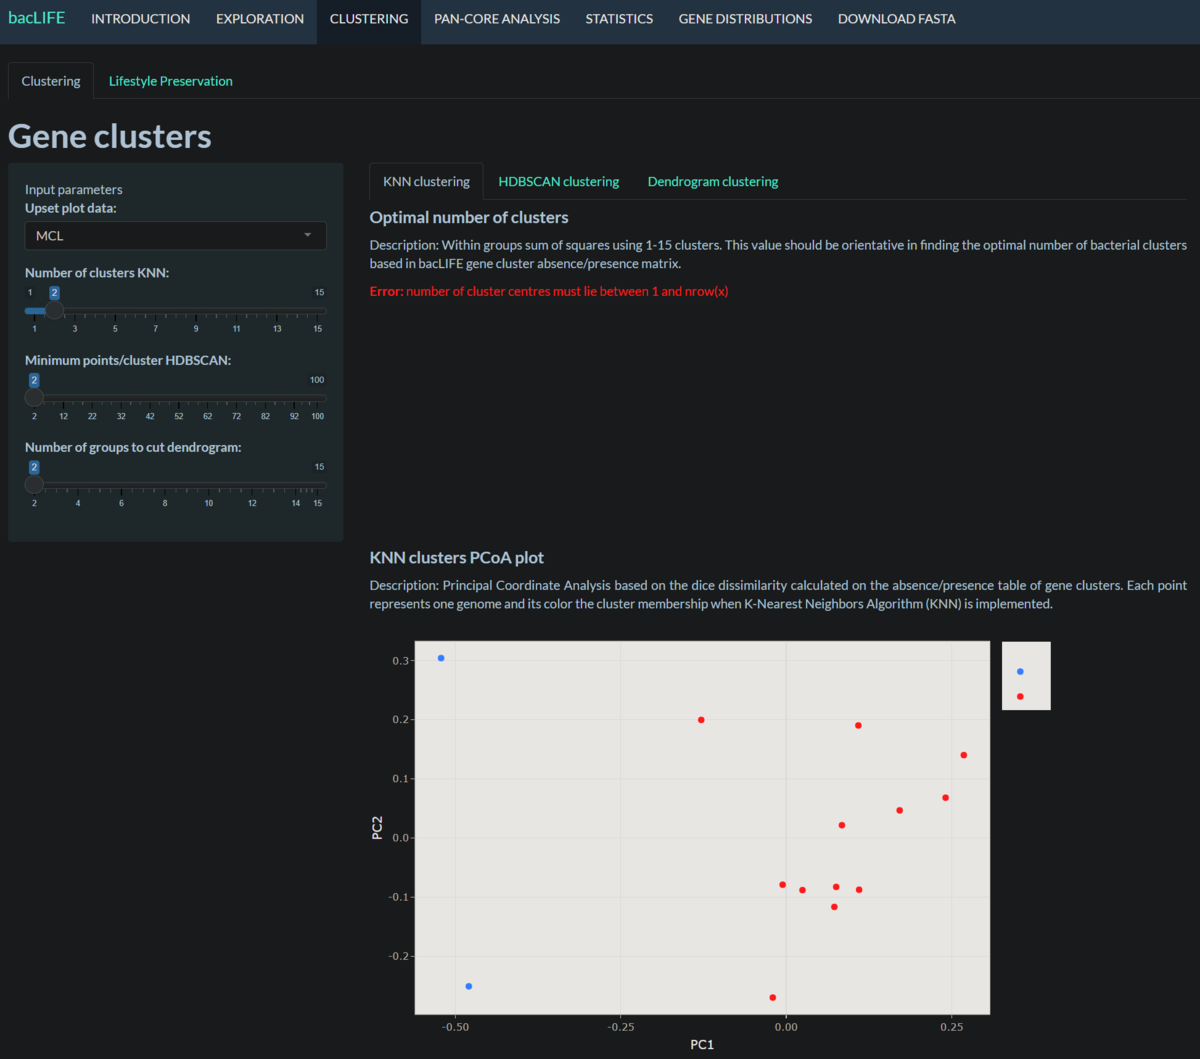
Clustering
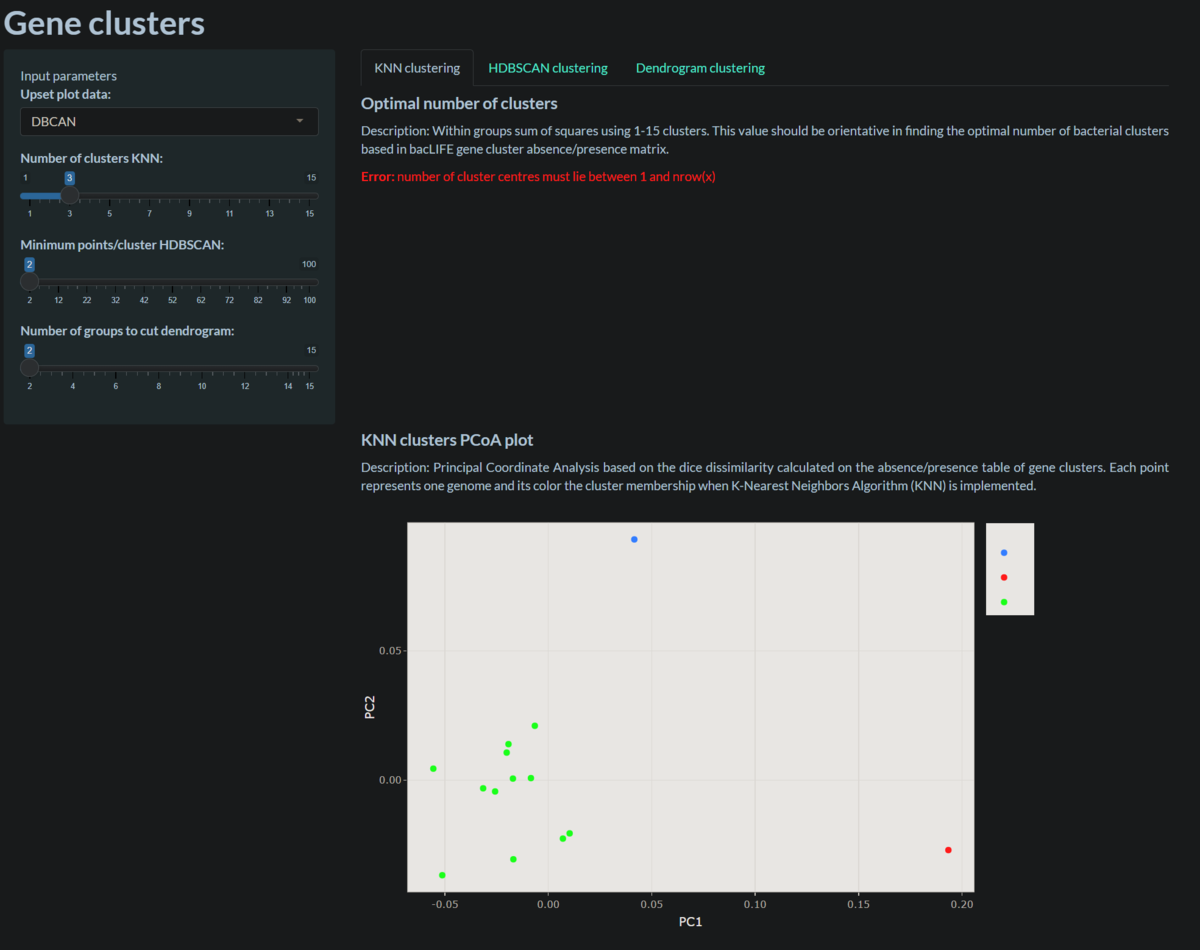
DBCANに切り替え、クラスタ数3。
Pan-genome
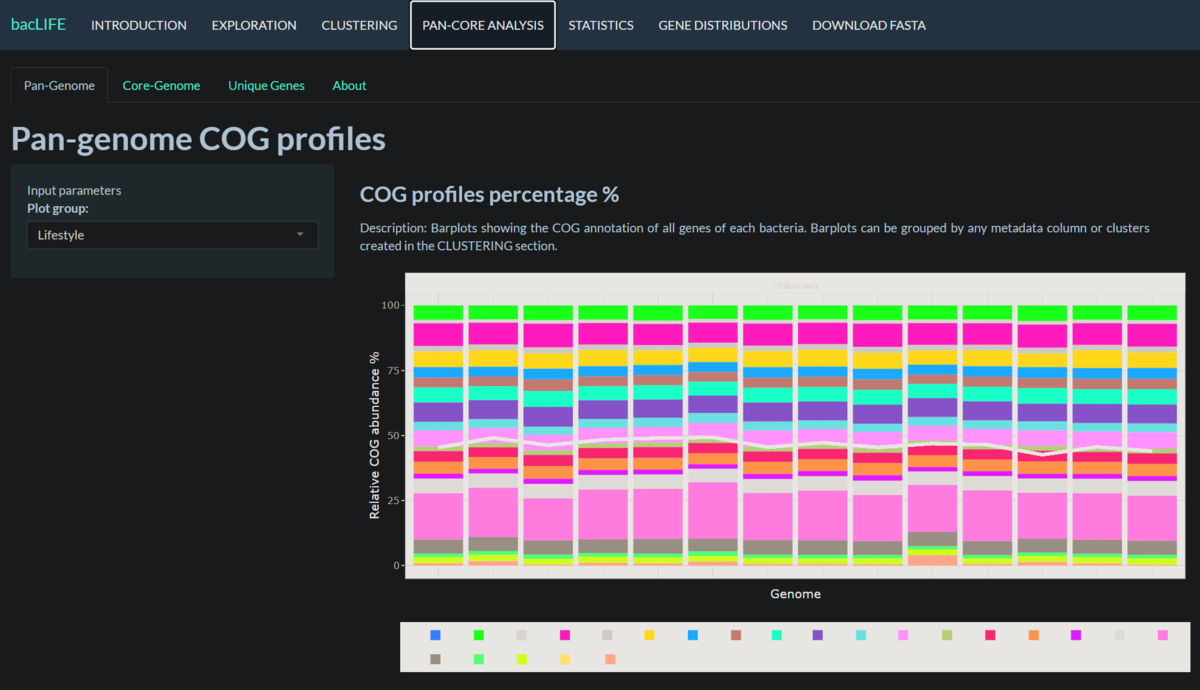
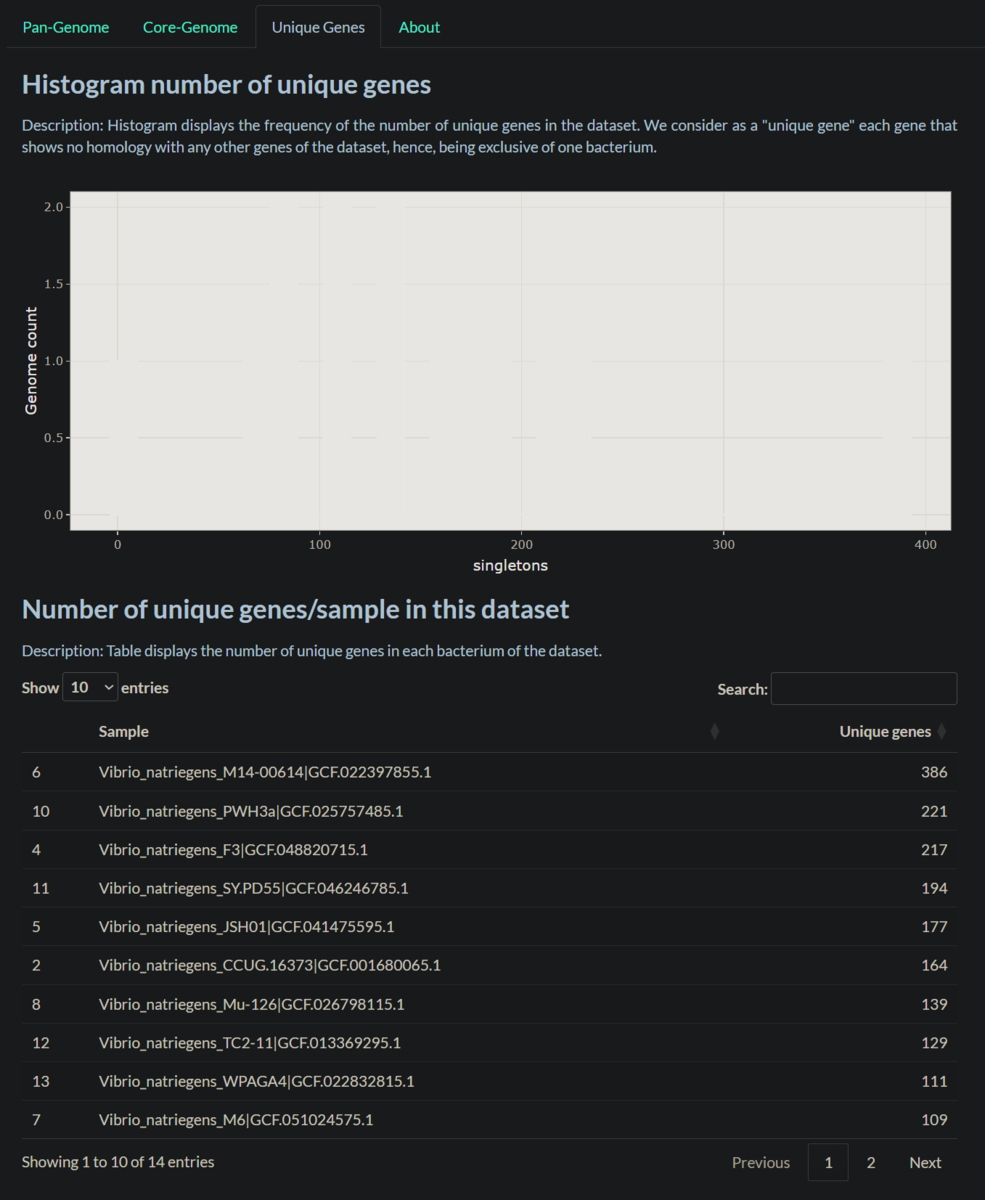
Unique genes tab
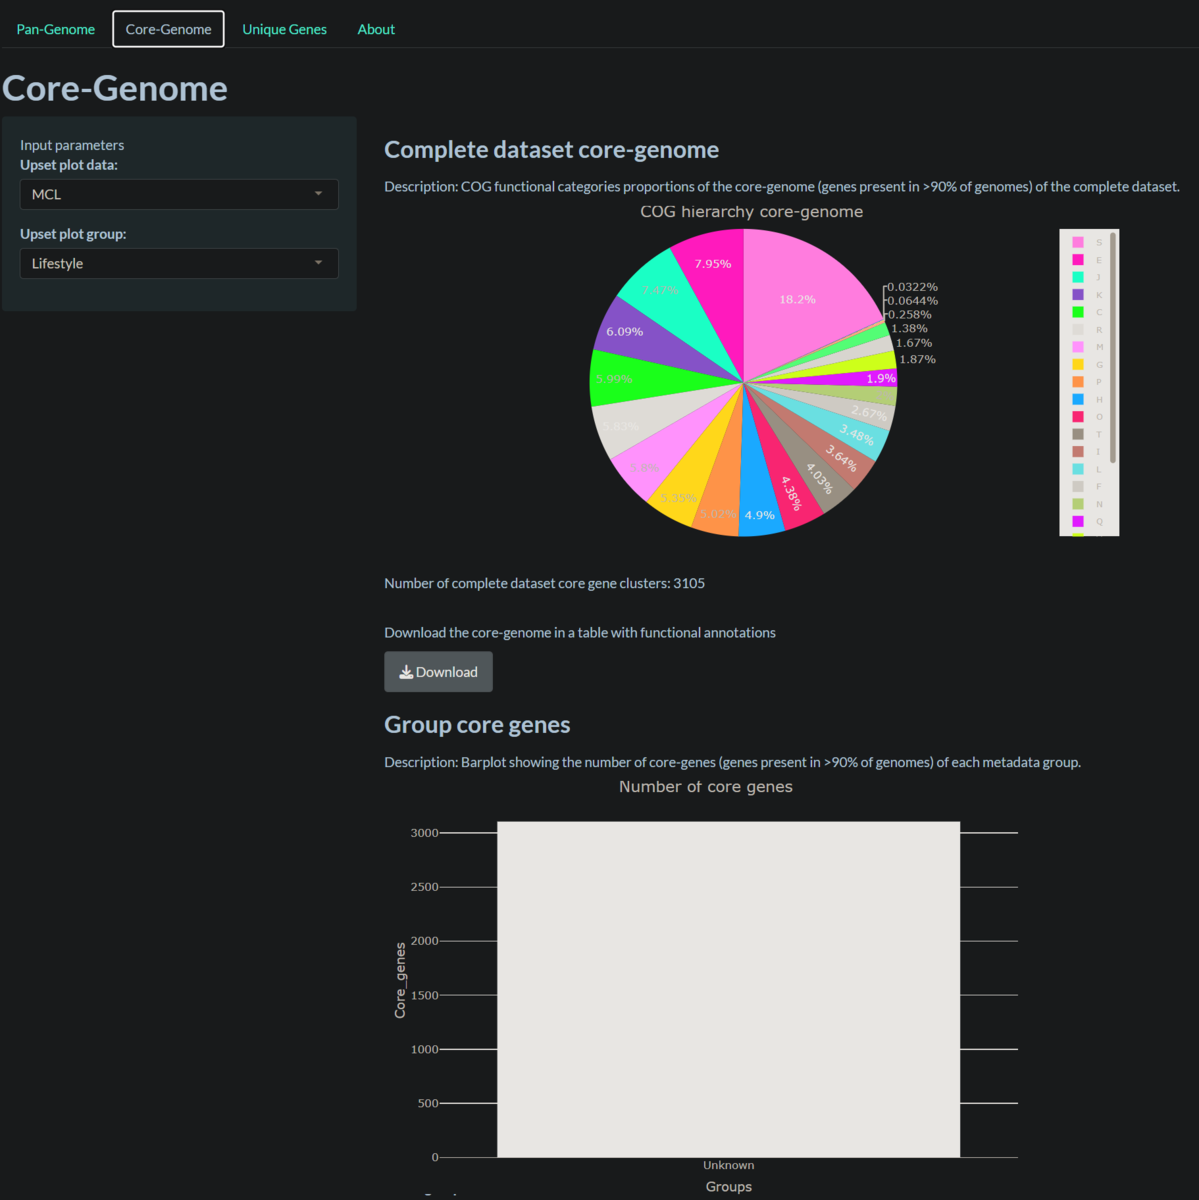
Core genesタブ
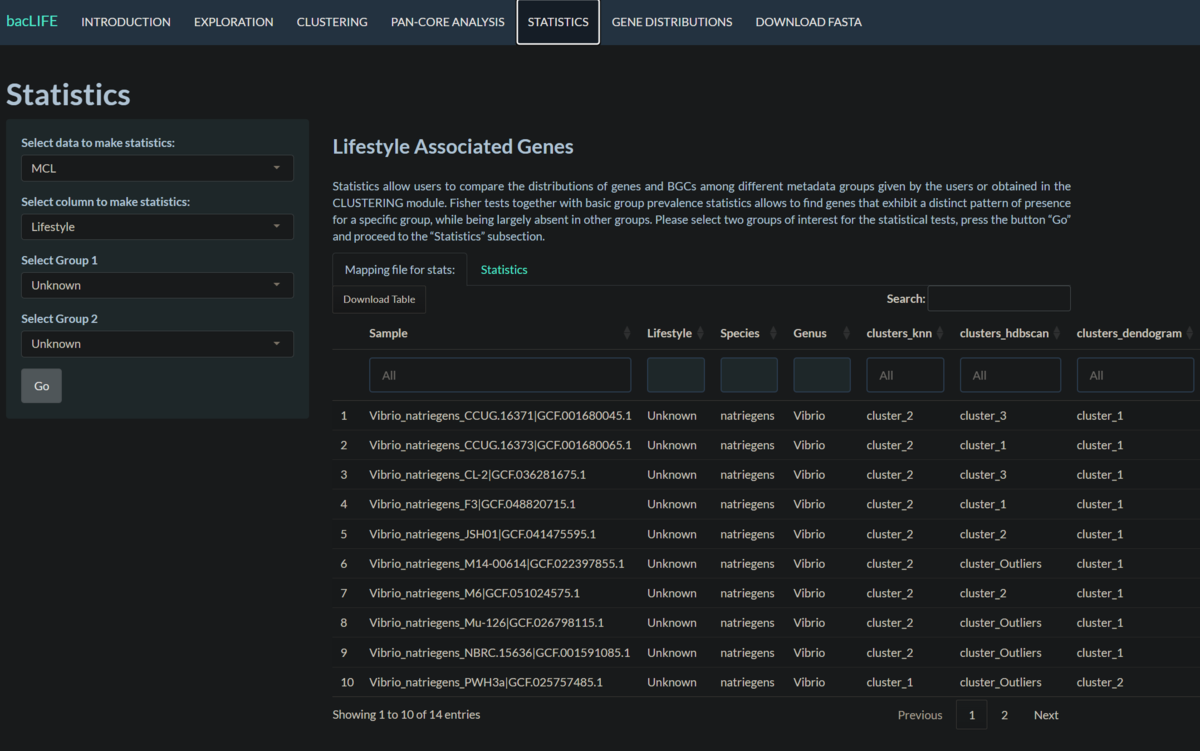
Statistics
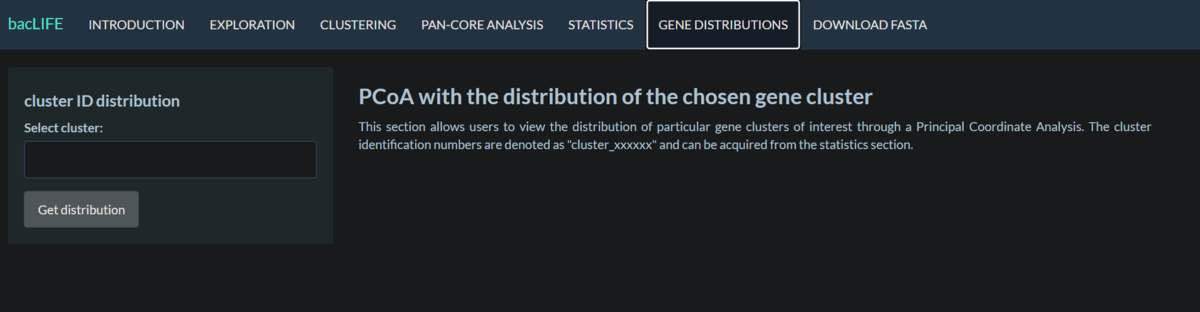
Gene distributions
その他
- 論文では、Burkholderia/ParaburkholderiaおよびPseudomonasの16,846ゲノムを解析している。
- bacLIFEは、ゲノムアノテーション、遺伝子クラスタリング、BGC解析、機械学習による生活様式予測、Shinyによる可視化を1つのワークフローとしてまとるため、Snakemake、conda仮想環境、Prokka、antiSMASH、BiG-SCAPE、Shinyアプリなどを組み合わせている。
- bacLIFEの長所は、多様な解析ツールを論理的・自動的・インタラクティブな比較ゲノミクスフレームワークに統合した点にある(論文より)。
引用
bacLIFE: a user-friendly computational workflow for genome analysis and prediction of lifestyle-associated genes in bacteria
Guillermo Guerrero-Egido, Adrian Pintado, Kevin M. Bretscher, Luisa-Maria Arias-Giraldo, Joseph N. Paulson, Herman P. Spaink, Dennis Claessen, Cayo Ramos, Francisco M. Cazorla, Marnix H. Medema, Jos M. Raaijmakers & Víctor J. Carrión
Nature Communications volume 15, Article number: 2072 (2024)
関連
Snakefileの構文エラーが複数発生した。Snakefileを以下のように修正した。元の仮想環境なら不要。
mamba create -n bacLIFE_snakemake7 -c conda-forge -c bioconda python=3.11 snakemake=7.32.4 -y
conda activate bacLIFE_snakemake7
mamba install -c conda-forge -c bioconda bioawk mmseqs2 diamond mcl r-base biopython -y
mamba install -c conda-forge r-reshape2 r-dplyr r-tidyr r-data.table r-stringr r-readr bioconda bioconductor-biostrings r-splitstackshape r-tidyverse -y
mamba install -c conda-forge r-shiny r-shinydashboard r-dt r-plotly r-ape r-circlize r-tidyverse -y
conda activate bacLIFE_snakemake7
mamba install -c conda-forge -c bioconda \
r-shiny \
r-readr \
r-upsetr \
r-data.table \
r-dplyr \
r-dbscan \
r-shinydashboard \
r-scales \
r-shinythemes \
r-plotly \
r-dt \
r-reshape2 \
r-ggplot2 \
r-gridextra \
r-gplots \
r-gtools \
r-rcolorbrewer \
r-viridis \
r-rmarkdown \
r-heatmaply \
r-pals \
r-ape \
r-stringdist \
bioconductor-biocgenerics \
bioconductor-biostrings \
r-tidyr \
r-stringr \
r-vegan \
r-writexl \
r-paralleldist \
-y
