2026/07/28追記
ロングリード・アンプリコンシーケンシングはショートリードに比べて長い配列を解析できるが、ノイズを含む長いリードからアンプリコン配列バリアント(ASV)を特定・抽出することは困難な課題である。本研究では、Oxford Nanopore Technologies(ONT)のR10.4やPacBio HiFiリードを含む、平均精度98%以上の最新ロングリード・アンプリコンデータからASVを抽出するアルゴリズムsavontを提案する。Savontは、ONTによる全長16S rRNA解析において、従来の手法よりも5〜16倍低いシーケンシングデプスで解析が可能であり、複雑な環境サンプルに対しては最大95倍多くのASVを生成する。Savontにより、デプスが浅くノイズを含むロングリード・アンプリコンシーケンシングデータを用いたASVベースの解析が実現可能となる。
Savontワークフロー。

(論文より転載)
Savontは、最初にサンプル内の多型k-merペアであるSNPmerを生成する。SNPmerは、k-merの文脈に固定された二対立SNPをリファレンス非依存的に表現したものである。SNPmerを用いてリードをクラスタリングすることで、1塩基多型も区別できる。各クラスターはpartial order alignmentによってコンセンサス配列へ変換され、低品質配列とキメラを除去することで、最終的なASVが得られる。
Amplicon sequence variant
https://en.wikipedia.org/wiki/Amplicon_sequence_variant
インストール
Github
mamba create -n savont -y
conda activate savont
mamba install -c bioconda savont -y
> savont
savont - high-resolution ASV (Amplicon Sequence Variant) generation and taxonomic profiling for ONT R10.4/HiFi long-read amplicon sequencing
Usage: savont [OPTIONS] <COMMAND>
Commands:
asv Turn >~ 98% accuracy long reads into ASVs (Amplicon Sequence Variants)
classify Classify ASVs against a reference database and generate taxonomy abundance table at species/genus level
download Download reference databases for savont (EMU, SILVA, or GreenGenes2)
sintax K-mer bootstrap against a database for genus-level classification with the SINTAX algorithm
export Export ASV results to QIIME2-compatible format + combine multiple savont outputs by dereplicating ASVs
Options:
-l, --log-level <LOG_LEVEL> Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
-h, --help Print help
-V, --version Print version
> savont asv -h
Turn >~ 98% accuracy long reads into ASVs (Amplicon Sequence Variants)
Usage: savont asv [OPTIONS] <FASTQ/FASTA>...
Arguments:
<FASTQ/FASTA>... Input read file(s) in FASTQ or FASTA format (.gz supported). Multiple files are concatenated unless `--pooled-samples` is specified, in which case each file is treated as a distinct sample
Options:
-o, --output-dir <OUTPUT_DIR> Output directory for results (created if it does not exist) [default: savont-out]
-t, --threads <THREADS> Number of threads to use for parallel processing [default: 20]
-l, --log-level <LOG_LEVEL> Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
--no-band Use exact (unbanded) POA alignment for consensus generation; slower but handles highly variable clusters
-h, --help Print help
Parameter Presets:
--fl-16s 16s rRNA full length (~1500 bp) amplicon preset (default; does nothing)
--hifi PacBio HiFi amplicon preset (--min-cluster-size 4)
--rrna-operon rRNA operon (~4000 bp) amplicon preset (--min-read-length 3500 --max-read-length 5000)
Multi-sample pooling:
--pooled-samples Per-sample quantification: treat each input file as a distinct sample. Reads are pooled for ASV calling; depths are quantified per file
Input/Output Options:
-m, --min-read-length <MIN_READ_LENGTH>
Minimum read length for reads [default: 1100]
-M, --max-read-length <MAX_READ_LENGTH>
Maximum read length for reads [default: 2000]
--quality-value-cutoff <QUALITY_VALUE_CUTOFF>
Minimum estimated read accuracy (%) to include in clustering [default: 98]
--minimum-base-quality <MINIMUM_BASE_QUALITY>
Minimum base quality to be considered high-quality for SNPmer detection. Set lower for older reads [default: 25]
Clustering Parameters:
-s, --single-strand
Use only forward strand k-mers (for strand-specific protocols)
--min-cluster-size <MIN_CLUSTER_SIZE>
Minimum number of reads required to keep a cluster (ASV) [default: 12]
Consensus Parameters:
-n, --n-depth-cutoff <N_DEPTH_CUTOFF>
Minimum depth required for sequences with ambiguous bases to be included in output [default: 250]
-u, --use-hpc
Use homopolymer compression for clustering and consensus generation. Helps for complex, eukaryotic genomes
--mask-low-quality
Mask low-quality bases in consensus sequences (set to 'N' if below posterior probability threshold)
-p, --posterior-threshold-ln <POSTERIOR_THRESHOLD_LN>
Negative alternate posterior probability threshold (natural log scale) for base consensus. Higher = more stringent for low-quality consensuses. Do not set higher than min_depth * ln(error_rate) [default: 30]
--low-polymorphism
Low-polymorphism mode: skips SNPmer clustering and uses minimap2 for read-to-ASV mapping. Auto-enabled when >75% of reads have no SNPmers (e.g. single-strain samples)
Chimera Detection Options:
--chimera-allowable-errors <CHIMERA_ALLOWABLE_ERRORS>
Allowable errors for bi-chimeric detection (higher = more sensitive but may filter out true ASVs) [default: 1]
--chimera-detect-length <CHIMERA_DETECT_LENGTH>
Length of near-perfect asv segment matches to consider for chimera detection (higher = less sensitive). Default is 1/10 of the minimum read length
> savont classify -h
Classify ASVs against a reference database and generate taxonomy abundance table at species/genus level
Usage: savont classify [OPTIONS] --input-dir <INPUT_DIR> --db <DB>
Options:
-i, --input-dir <INPUT_DIR>
Directory containing clustering results
-o, --output-dir <OUTPUT_DIR>
Output directory for classification results. Default: same as the input directory
-t, --threads <THREADS>
Number of threads to use for parallel processing [default: 20]
--species-threshold <SPECIES_THRESHOLD>
Minimum identity threshold for species-level classification (default: 99%) [default: 99]
--genus-threshold <GENUS_THRESHOLD>
Minimum identity threshold for genus-level classification (default: 94.5%) [default: 94.5]
-l, --log-level <LOG_LEVEL>
Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
--detailed-unclassified
Explicitly output "UNCLASSIFIED-(asv_header)" for unassigned ranks in species/genus columns instead of using "UNCLASSIFIED"
-h, --help
Print help
Database:
-d, --db <DB> Path to a savont database directory. The database type is auto-detected from the directory name or a `.savont_db` marker file written at download time (e.g. `databases/emu`)
> savont download -h
Download reference databases for savont (EMU, SILVA, or GreenGenes2)
Usage: savont download [OPTIONS] --location <LOCATION> --dbs <DB>...
Options:
--location <LOCATION> Directory under which each database will be saved as a subdirectory
--dbs <DB>... One or more databases to download. Each is saved to `<location>/<keyword>` and usage is `savont classify -d <location>/<keyword>` [possible values: emu-1, silva-138.2, greengenes2-2024.09]
-l, --log-level <LOG_LEVEL> Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
-h, --help Print help
> savont sintax -h
K-mer bootstrap against a database for genus-level classification with the SINTAX algorithm
Usage: savont sintax [OPTIONS] --input-dir <INPUT_DIR> --db <DB>
Options:
-i, --input-dir <INPUT_DIR> Directory containing clustering results (must contain final_asvs.fasta)
-o, --output-dir <OUTPUT_DIR> Output directory for classification results. Default: same as input directory
-t, --threads <THREADS> Number of threads to use for parallel processing [default: 20]
--min-bootstrap <MIN_BOOTSTRAP> Minimum bootstrap confidence threshold for genus and all higher ranks [default: 0.8]
-l, --log-level <LOG_LEVEL> Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
--n-iter <N_ITER> Number of bootstrap iterations [default: 100]
--detailed-unclassified Explicitly output "UNCLASSIFIED-(asv_header)" for unassigned ranks in species/genus columns instead of using "UNCLASSIFIED"
-h, --help Print help
Database:
-d, --db <DB> Path to a savont database directory
> savont export -h
Export ASV results to QIIME2-compatible format + combine multiple savont outputs by dereplicating ASVs
Usage: savont export [OPTIONS] --input-dirs <INPUT_DIRS>... --output-dir <OUTPUT_DIR>
Options:
-i, --input-dirs <INPUT_DIRS>... Input directories containing savont asv (and optionally classify/sintax) output. Each directory must contain final_asvs.fasta
-o, --output-dir <OUTPUT_DIR> Output directory for exported results
--no-fuzzy ASVs that are 10 bp shorter or longer than another ASV but 100% identical to it are merged by default. Disable this behavior to keep all ASVs separate (not recommended)
--relabel <LABEL>... Override auto-detected sample names (# of labels has to match the total # of samples). Useful when the read filename embedded in the feature table is ambiguous
-l, --log-level <LOG_LEVEL> Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]
-h, --help Print help
実行方法
Savontは、98%を超える精度を持つロングリードに最適化されている。ONTのR10.4リード(SUPベースコーリング使用)やPacBio HiFiリードの使用が推奨されている。
アダプター配列をトリミング済みのロングリードを指定する。PacBioのCCS技術などで得たHiFiロングリードは"--hifi"を付ける。デフォルトでは、約1,500 bpのfull-length 16S rRNAアンプリコン用の設定(--fl-16s)が使用される。
#ONT R10.4 with SUP basecalling
savont asv ONT.trimmed.fq.gz -o outdir -t 8

#HiFi
savont asv tests/data/ont_zymo_1000.trimmed.fq.gz -o outdir -t 8 --hifi
- -o Output directory for results (created if it does not exist) [default: savont-out]
- -t Number of threads to use for parallel processing [default: 20]
- --hifi PacBio HiFi amplicon preset (--min-cluster-size 4)
- --fl-16s 16s rRNA full length (~1500 bp) amplicon preset (default; does nothing)
- --min-cluster-size Minimum number of reads required to keep a cluster (ASV) [default: 12]
"--hifi"を付けない場合はONT向けの設定となり、ASVラスターの最小リード数はデフォルトの12となる。一方、HiFiリードは塩基精度が高いため、--hifiでは最小クラスターサイズが4まで引き下げられる。
savontはASV生成だけでなく、ASVの分類データベースを使った分類学的分類、QIIME 2形式への出力までサポートしている。savont classifyにはsavont asvコマンドの出力を指定する。
#1 3つのDBをまとめて取得する
savont download --location ./database --dbs greengenes2-2024.09 emu-1 silva-138.2
=> database/に3つのDBフォルダができる

#2 taxonommic classification、ここではsilva DBを指定(紹介)
savont classify -i savont-test-single/ -d database/silva-138.2/ -t 8

#3 export (ASVの結果だけあれば認識する)
savont export -i savont-test-single/ -o export_dir
=> savont asvの出力ディレクトリに結果は保存される。
pooled sample
savont asv --pooled-samples sample1.fq.gz sample2.fq.gz sample3.fq.gz
- --pooled-samples Per-sample quantification: treat each input file as a distinct sample. Reads are pooled for ASV calling; depths are quantified per file
=>全リードをプールして共通のASV配列セットを決定し、存在量はサンプルごとに別々に算出する。同じアンプリコンの異なるデータをプールしてASV配列セットを作ることで、統一して解析でき、さらにプールすることでシークエンシングデプスを稼ぐことができる。
rRNAオペロン
savont asv ONT.trimmed.fq.gz -o outdir -t 8 --rrna-operon
- --rrna-operon rRNA operon (~4000 bp) amplicon preset (--min-read-length 3500 --max-read-length 5000)
strand specific
savont asv ONT.trimmed.fq.gz -o outdir -t 8 --single-strand
- -s, --single-strand Use only forward strand k-mers (for strand-specific protocols)
rRNAオペロン全長や16Sでない場合、増幅長の下限と上限サイズを指定する。
savont asv ONT.trimmed.fq.gz -o outdir -t 8 --min-read-length 1600 --max-read-length 2100
- -m, --min-read-length Minimum read length for reads [default: 1100]
- -M, --max-read-length Maximum read length for reads [default: 2000]
QIIME 2にインポート可能なTSV形式で出力し、さらにbiome convertで変換、そのままQIIME 2でアンプリコン解析する。savont exportではsavont asvの出力を指定する(分類までしていないてもexportコマンドは使える)。
#1 export
savont export -i savont-asv_outdir -o export_dir
#複数同時も可能
savont export -o exportdir -i sample1_dir sample2_dir sample3_dir

#2 さらにBIOM形式変換ツールでBIOM形式へ変換
#installは"mamba install conda-forge::biom-format -y”
biom convert -i exportdir/merged_feature_table.tsv \
 -o feature-table.biom --table-type="OTU table" --to-hdf5

#3 QIIME2にimport、3回に分ける。(qiimeのインストール *1)
#3-1 まずASVのカウント表をimport
qiime tools import --type "FeatureTable[Frequency]" \
 --input-path feature-table.biom --output-path feature-table.qza

#3-2 次にASV塩基配列をimport
qiime tools import --type "FeatureData[Sequence]" \
 --input-path export-out/merged_rep_seqs.fasta --output-path rep-seqs.qza

#3-3 最後にASVの分類結果をimport
qiime tools import --type "FeatureData[Taxonomy]" \
 --input-format HeaderlessTSVTaxonomyFormat --input-path export-out/merged_asv_taxonomy.tsv --output-path taxonomy.qza

#4 QIIME2コマンド例
#サマリーコマンド: 総リード数、検出ASV数、各ASVの出現頻度
qiime feature-table summarize \
 --i-table feature-table.qza \
 --o-feature-frequencies feature-frequencies.qza \
 --o-sample-frequencies sample-frequencies.qza \
 --o-summary feature-table-summary.qzv
=> QIIME2の.qza形式に変換され、QIIME2で解析できるようになる。QIIME2の結果の棒グラフや代表配列などはQIIME2 View(論文)で閲覧できる。

テストラン
tests/data/に、Zymo mockコミュニティをONTで読んでアダプターをトリミングしたと思われるont_zymo_1000.trimmed.fq.gzが用意されている。
1、savont asvコマンドの実行
git clone https://github.com/bluenote-1577/savont.git
cd savont/
#ONT
savont asv tests/data/ont_zymo_1000.trimmed.fq.gz -o outdir -t 4 -l info
- -l Logging verbosity level [default: info] [possible values: error, warn, info, debug, trace]

このONT.fastqには900リードほど含まれているが、1-2秒で終了した (9900X)。
出力例
outdir/

> head feature-table.tsv

入力リードとASVのfastaの配列数の比較

入力の902リードから18個のASVが検出された。Zymo mock communityに含まれる細菌種数を考えると、この値は実際の種数にかなり近く、完全に一致している可能性もある。
2、savont downloadコマンドの実行。Greengenes2、EMU、SILVA 138.2のデータベースを取得する。
savont download --location database --dbs greengenes2-2024.09 emu-1 silva-138.2
- --location Directory under which each database will be saved as a subdirectory
- --dbs One or more databases to download. Each is saved to `<location>/<keyword>` and usage is `savont classify -d <location>/<keyword>` [possible values: emu-1, silva-138.2, greengenes2-2024.09]

出力例
database/
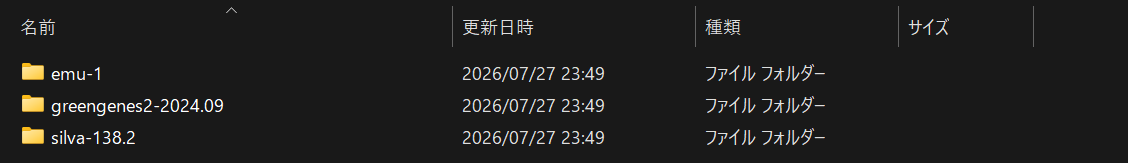
3、savont classifyコマンドの実行。asvコマンドの出力ディレクトリとDBを指定する。出力ディレクトリを指定しないとasvのディレクトリに書き出される。
#SILVAを指定
savont classify -i savont-test-single/ -d database/silva-138.2/ -t 10 -o outdir
- -i Directory containing clustering results
- -o Output directory for classification results. Default: same as the input directory
- -t Number of threads to use for parallel processing [default: 20]
- --species-threshold Minimum identity threshold for species-level classification [default: 99]
- --genus-threshold Minimum identity threshold for genus-level classification [default: 94.5]
outdir/

species_abundance.tsv

ASVの分類結果を種レベルでまとめた表。左端にabundance列がある。ASVコマンドでは18配列出力されたが、11配列分しかないように見える。logをみると、異なる6個のASVが1つの種にアサインされたためだとわかった。
genus_abundance.tsv

ASVの分類結果を属レベルでまとめた表。種より少ないのは上と同じ理由。
asv_mappings.tsv

各ASV配列を、指定したデータベースへ照合した結果。種からスーパーキングダムまでのすべての分類階級が含まれている。アラインメントの同一性が低い場合、下位の分類階級はUNCLASSIFIED(未分類)となることがある。マッピングされなかったASVについては、すべての階級の列にUNCLASSIFIEDと記載される。上の表でASVコマンド出力の18配列よりも行数があるのは、同率のベストヒットが複数あるため。
論文より
- アンプリコンシーケンシングでは、例えば分類プロファイリングに用いられる16S rRNA遺伝子のように機能的情報や分類学的情報を得ることができる。重要な計算上の課題は、これらのマーカー内に存在する真の変異を、シーケンシングノイズから1塩基精度で識別することである[3,4,5,6]。このように推定された、ノイズを含まない配列はアンプリコン配列バリアント(amplicon sequence variants:ASV)と呼ばれる (ASVは、97%類似度でまとめるOTUとは異なり、原則として1塩基単位で異なる正確なアンプリコン配列である)。
- 従来のショートリードアンプリコンは数百塩基対程度の領域を標的としており、全ゲノム解析と比べて分解能が低い[7]。一方、ロングリードシーケンシングの登場により、全長16S rRNA遺伝子[8]やrRNAオペロン全体[9]など、より長いアンプリコンを解析できるようになった。この配列長の増加によって分解能は著しく向上し、微生物を種レベルあるいは株レベルでプロファイリングする用途に利用できる[10]。この高い分解能を活用するためには、一定の配列同一性閾値、例えば97%でクラスタリングされたoperational taxonomic unit(OTU)ではなく、真のASVを生成することが重要である[6]。
- denoisingは、リード集合の中からエラーを含まないリードを特定することに依存している。しかし、アンプリコンが長く、シーケンシングノイズが大きい場合、エラーを含まないロングリードはまれである可能性がある(論文Fig. 1a)。最近の研究では、8種からなる単純なモックコミュニティであっても、ONT R10.4リードにdenoisingアルゴリズムを用いてすべてのASVを回収するには、少なくとも50,000リードが必要であることが示された[14]。
-
従来のショートリード向けに設計されたDADA2やUNOISE3のようなdenoising法は、基本的に、エラーを含まない完全なリードが、深く読んでいるために同じ配列について複数存在することを利用する。しかし約1.5 kbの全長16S rRNAや、約4 kbの16S–ITS–23Sオペロンでは、全塩基が正しいリードはほとんどなくなる。savontはこの前提を捨て、エラーのないリードを探すのではなく、エラーを含むリード同士から真の変異を推定する。エラーを含むリードを、真の塩基多型を手掛かりにクラスタリングし、クラスタごとにコンセンサス配列を作るというアプローチを採用している。
- Savontでは、ロングリードは長さと品質に基づいてフィルタリングされる。デフォルトでは、完全長16S rRNAアンプリコンを想定し、長さが1100未満または2000を超えるリードを除外する。また、塩基品質を用いて、推定精度(平均値)が98%未満のリードも除外する。残ったリードは、事前に特定されたSNPmerを用いてインデックス化されるが、その際、デフォルトではSNPmerの中央の塩基の品質が25を超えていることが条件となる。さらに、FracMinHash [31]を用いてk-mer(必ずしもSNPmerである必要はない)のスケッチを行い、およそc個に1個のk-mer(デフォルトではc=11)を保持する。これらSNPmerとk-merの両方を使用し、2段階のプロセスでクラスタリングを行う(4.3 Primary k-mer clusteringと4.4 Secondary SNPmer clusteringを参照)。
引用
Sensitive long-read amplicon sequence variant recovery with savont
Jim Shaw, Marie Riisgaard-Jensen, Kasper Skytte Andersen, Rasmus Kirkegaard, Morten Kam Dahl Dueholm, Heng Li
bioRxiv, Posted May 29, 2026.
関連
参考
For years you needed UMIs and similar dark molecular biology magic to get perfect amplicon sequences from @nanopore . With recent accuracy improvements+really clever algorithms that is now changed. Savont unlocks ASVs from low coverage amplicons 🤯🤯🤯https://t.co/pGmvwHBdzr
— Rasmus Kirkegaard (@kirk3gaard) May 30, 2026
*1 macへのQIIME2インストール(まだappleシリコンネイティブがanacondaで配布されていない)インストールはmambaでも重く、10-30分かかる
conda activate base
CONDA_SUBDIR=osx-64 mamba env create --name qiime2-2026.7 --file\
https://raw.githubusercontent.com/qiime2/distributions/refs/heads/dev/2026.7/qiime2/released/rachis-qiime2-osx-64-conda.yml
conda activate qiime2-2026.7
