ウイルスゲノム配列の急速な蓄積は、アウトブレイクによる過剰表現によって引き起こされる計算上の制約とサンプリングバイアスのために、多重配列アライメント、系統発生、ゲノム/アライメント可視化などの下流解析ツールに大きな課題をもたらしている。クラスタリングによる代表ゲノムの選択は、ランダムサブサンプリングの原理的な代替手段となるが、適切なクラスタリング戦略の選択は簡単ではなく、状況に依存する。ここでは、大規模なウイルスゲノムデータセットからバイアスを考慮した代表選択を行うモジュール式のNextflowパイプライン、ViralClustを紹介する。ViralClustは、統一されたワークフロー内に5つの異なるクラスタリングアルゴリズム(CD-HIT-EST、SUMACLUST、VSEARCH、MMSeqs2、およびHDBSCAN)を統合し、選択された配列のバランスの取れた系統分布を考慮しながら、クラスタリング結果を直接比較し、さまざまな生物学的問題に柔軟に適応できるようにする。 632~156,586配列、890~197,185ヌクレオチドのゲノム長にわたる6つのRNAおよびDNAウイルスデータセットでViralClustを評価した。すべてのデータセットにおいて、クラスタリングによってデータセットサイズが95%以上削減された。同時に、種、属、科をまたぐ遺伝的多様性は維持され、アウトブレイク、部分ゲノム、配列方向アーティファクトによってもたらされるバイアスも効果的に軽減された。ViralClustは、全ゲノムクラスタリングとスケーラブルな代表選択をサポートすることで、計算上不可能であった効率的かつ再現性の高い下流解析を可能にする。このフレームワークは、大規模なウイルスゲノミクスのための柔軟な基盤を提供し、比較解析やウイルス分類といった将来のアプリケーションをサポートする。
レポジトリより
特定のウイルスを、同じ属、あるいは科に属する他のすべてのウイルスと比較したいと思ったことはないだろうか?一部の分類群では、比較ゲノミクスに使用できる様々なゲノムが利用できる。しかし、多くの場合、ウイルスゲノムデータセットは冗長であり、下流の解析にバイアスをもたらす。冗長性を排除するために、入力配列をクラスタリングすることは良いアイデアだが、扱っている科学的問題を考えると、クラスタリングアルゴリズムが適切かどうかを判断するのは困難を伴う。ViralClustはこの目的のために開発された。これは、データセットに対して様々なクラスタリング手法と実装を一度に活用するNextflowパイプラインである。これをNCBIのメタ情報と組み合わせることで、各ツールの代表的なゲノムを探索し、解析に適したクラスタの決定を迅速に行うことができる。
現在、入力ゲノムのクラスタリングには5つの異なるアプローチが用いられている。CD-HIT、Sumaclust、vsearchはすべて同じアルゴリズムを実装しているが、それぞれのヒューリスティックには微妙な違いがある。さらに、MMSeqs2のクラスタリングモジュールも利用している。最後に、ViralClustはUMAPとHDBSCANを用いて実現されたk-merベースのクラスタリング手法を実装している。
インストール
依存
- nextflow
git clone https://github.com/klamkiew/ViralClust.git
cd ViralClust

#ここでは*1のレシピを使用
mamba env create -f env.yml
conda activate nextflow
テストラン
"--fasta"でウィルス配列のパスを指定する。
cd ViralClust
nextflow run viralclust.nf --fasta "data/test_input.fasta"
condaで各ステップごとに個別の環境が作られ、解析が進んでいく (ネットに繋がっている必要がある)。

テストデータには374配列 (平均長10,844塩基(対))含まれている。
終了まで6分ほどかかった。

出力例
viralclust_results/

09-evaluation/

test_input_positive_nr_cdhitest_mafft_fasttree.nwk_nwdisplay.pdf

09-evaluation/test_input_summary.csv

summary/

summary/clustered_sequences/

test_input_summary.csv
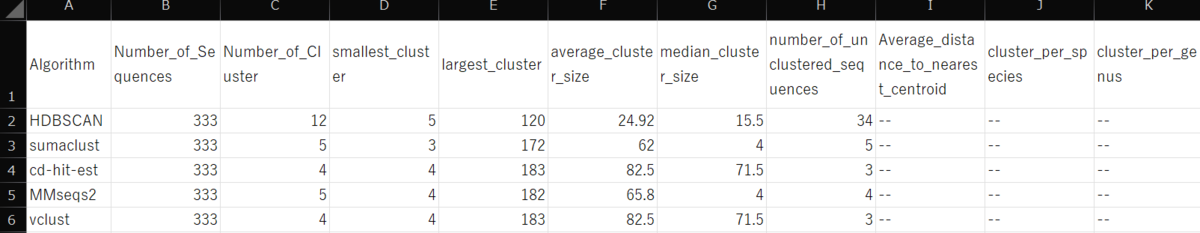
summary/web/viralclust.html #開くのに少し時間がかかる

クラスタリングツールごとに、ユーザーが指定したウィルス配列がどのクラスタに分類されたか示されている。強力にクラスタリングされているため、初期374配列は5つ全ての手法で4~12配列(クラスタ)まで減っている。
レポジトリより
- "--goi <PATH>"で特定のfastaファイルを指定すると、ViralClust は この.fasta に存在するすべてのゲノムを最終的な代表シーケンスセットに含めるように指示する(テストデータ: data/goi_test_refseq.fasta)。
- "--eval"を付けると、クラスタリング後にクラスタリング結果の基本統計が出力される。
- "--ncbi"フラグを"--eval"と共に付けると、基本統計の評価に加えて、入力セットの全ゲノムに対してNCBIメタ情報が追加される(fastaレコードの識別子から GenBank アクセッションIDがスキャンされ、配列の分類、アクセッション日、アクセッション国に関する情報が取得される)。--eval は暗黙的に呼び出される。データにデータベースがない場合、このフラグを設定すると、--ncbi_update が暗黙的に設定される。
- ViralClust は複数のクラスタリングアルゴリズムを実行しているため、どれが最も適切な結果を生成したかを判断するのは難しい場合がある。そのときに--evalと--ncbiが役立つ。
- "--update_ncbi"は、ViralClust のデータベースを更新する必要があるときに使用する。
- "--output <PATH>"で出力ディレクトリを指定できる。デフォルトではカレントに ViralClust_result フォルダが作成される。
- "--max_cores"と"--cores"で最大使用CPUコア数と個々のプロセスで使用するコア数を指定できる。
引用
Reducing haystacks to needles - ViralClust: A Nextflow pipeline to cluster viral sequences
Sandra Triebel, Kevin Lamkiewicz, Manja Marz
bioRxiv, Posted January 30, 2026.
関連
*1 以下のレシピで環境を作成
cat << 'EOF' > env.yml
name: nextflow
channels:
- conda-forge
- bioconda
- defaults
dependencies:
- python=3.10
- nextflow
- mmseqs2
- wget
EOF
