メタゲノム由来ゲノム(MAG)は、培養困難な微生物が持つ新規タンパク質配列へのアクセスを可能にし、タンパク質の多様性研究、構造予測、進化解析において極めて重要なリソースとなっている。しかし、MAG由来のタンパク質データが爆発的に増加している一方で、大規模なMAGタンパク質データセットに対して高速かつ高精度な類似性検索を行えるツールは依然として限られている。本著者らは、Microbiome Datahubに登録された21万以上のMAGに由来する4億のタンパク質配列(アミノ酸残基数1,000億)を対象とした、超高速な配列類似性検索ウェブサーバーPZLAST-MAGを開発した。PEZY-SC3 MIMDメニーコアプロセッサ上で実装されたPZLAST-MAGは、高い精度と速度を実現しており、ベンチマーク解析の結果、DIAMONDやMMseqs2といった広く利用されているツールに匹敵する性能を示している。PZLAST-MAGは、表形式のアラインメント結果に加え、MAG間における相同タンパク質の系統的・環境的分布や共起パターンのインタラクティブな可視化機能も提供する。これらの機能を組み合わせることで、多様な微生物系統にわたる機能的に重要な遺伝子の相同体探索(ホモログマイニング)を迅速に行いつつ、それらの分類学的および生態学的な背景を明らかにすることが可能になる。2つのユースケース解析により、代謝酵素遺伝子やプラスミド由来遺伝子の相同体探索における本ツールの有用性を示した。PZLAST-MAGはウェブサービスとして提供されており、登録不要で https://pzlast.nig.ac.jp/pzlast/mag から無料で利用できる。
膨大なMAG由来タンパク質の配列を高速検索する新しいウェブサーバー「PZLAST-MAG」が公開 - NBDC
help
https://pzlast.nig.ac.jp/pzlast/mag/about
webサービス
https://pzlast.nig.ac.jp/pzlast/magにアクセスする。

PZLAST-MAGを使用すると、大規模なメタゲノム由来ゲノム(MAG)データセットに対してタンパク質配列の検索を行うことができる。
クエリとして、タンパク質配列のFASTA形式ファイルを指定するか入力配列をボックスに貼り付ける(DNA配列は不可)。複数の配列を含むMulti-FASTAファイルも受け付ける。

配列は10 AA以上、10,000 AA以下の長さで、最大10,000配列且つ総アミノ酸数100,000以下である必要がある。また出力される可能性のある結果の総数は1,000,000以下である必要がある。

Output top N hits (入力配列ごとに何件のヒットを出力するか)、E-value(期待値)のカットオフ値を設定できる(デフォルトは1e-8)。
送信ボタンを押してジョブを登録する。
テスト時は、1配列のクエリで数分ほどかかった。
出力例
infoタブ - 結果はCSVとmulti-fastaとしてダウンロードできる。

Tableタブ
検索結果はBLASTと同様の表形式で表示される。

列のヘッダーをクリックすると、クエリ名で表を並べ替えできる。
MEOタブ
MicrobiomeDataHubでは、すべてのメタゲノムサンプルにMEOアノテーションが付与されている。MEO(Metagenome and Microbes Environmental Ontology)は、サンプルが採取された自然環境やヒト共生環境を統一的に記述するためのオントロジーである。MEOタブの棒グラフには、各MEO環境に関連付けられたMAGのうち、クエリにヒットしたMAGの数が表示される。その配列を持つ微生物が、どのような環境にいるのか把握できる。

Treeタブ
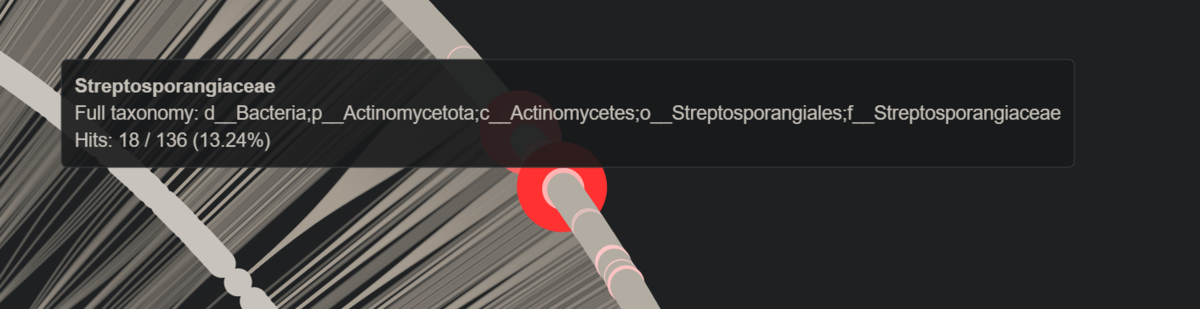
ヒットした配列の系統分布を系統樹上で可視化している。細菌および古細菌の科レベルまでの進化的な関係が系統樹として表示され、ヒットしたMAGに対応するノードは赤色で強調表示される。

系統樹上のノードにカーソルを合わせると、詳細な分類情報が表示される。
Coverageタブ
入力されたタンパク質クエリのN末端からC末端までの各アミノ酸位置における分類学的カバレッジが表示される。

これにより、特定のドメインが特定の分類群にのみ見られるといった関係性を発見できる可能性がある(helpより)。
Completionタブ
Completionタブでは、各MAGにおけるクエリタンパク質のヒット状況が表示される。Multi-FASTA形式で入力した複数のタンパク質配列について、各MAG内で何種類が検出されたかを集計し、その割合は「Completion ratio(完了率)」として示されている。

例えば、6種類のクエリタンパク質のうち3種類が同一MAGから検出された場合、完了率は50%となる。「Total hits」には、そのMAGにおけるクエリ配列の総ヒット数が表示される。この機能を利用することで、特定の代謝経路を構成する複数の酵素タンパク質が、同一MAG内にどの程度そろっているかを比較し、目的の代謝機能を持つ可能性の高いMAGを特定できる。
論文より
- 高速な配列類似性検索は、処理を4基のPEZY-SC3プロセッサ (MIMDアーキテクチャを採用したメニーコアプロセッサ) に分散し、各プロセッサの大規模な並列性を活用することで実現されている。各PEZY-SC3プロセッサは4096コアを搭載し、1コア当たり8つのハードウェアスレッドを実行できるため、1プロセッサ当たり合計32,768ハードウェアスレッドを利用できる。これにより、配列類似性検索を効率的に並列実行できる。
- 特殊な液浸冷却環境を必要としていた従来のPEZY-SC2システム上のPZLASTと比較して、現在のPEZY-SC3ベースのシステムは空冷方式を採用している。この変更により、特殊な冷却設備を用いることなく一般的なサーバーラックへ設置できるようになり、可搬性と実用性が大幅に向上した。さらに、PEZY-SC3はPEZY-SC2のおよそ2倍の計算資源を備えており、従来システムの基本的な並列化戦略を維持しながら、処理能力をさらに向上させている。
- PZLAST-MAGの配列類似性検索アルゴリズムは、基本的には従来のPZLASTと同一であり、概念的にはBLASTPに類似している(Mori et al. 2021)。すなわち、高速かつ高感度な配列類似性検索を実現するため、seed-and-extend戦略を採用している。伸長処理にかかる計算コストを削減するため、PZLAST-MAGでは、各シード周辺の限定された領域のみを計算するバンドアラインメントを採用している。主としてショートリード由来のタンパク質配列を対象としていた従来のPZLASTでは、この配列配置は固定されていた。これに対してPZLAST-MAGでは、実行時に長い配列を横軸、短い配列を縦軸へ動的に割り当てる適応的な方式を導入した。
-
PZLAST-MAGと2つの比較対象ツールDIAMONDとMMseqs2における適合率および再現率は、ほとんどのクエリタンパク質においてDIAMONDおよびMMseqs2と同程度だった。適合率は、いずれのツールでも概して高かった。一方、再現率はクエリによる変動が比較的大きかった (論文図2、メインFig.だが補足データとして提供されている)。
- PZLAST-MAGで使用される参照アミノ酸配列は、Microbiome Datahubデータベースから取得された。Microbiome Datahubの解析パイプラインでは、INSDCに登録された公開MAG配列から、MetaGeneAnnotatorを用いてタンパク質コード遺伝子が予測されている(Noguchi et al. 2008)。この参照データセットは、214,427個のMAGに由来する約143 GBのタンパク質配列から構成されており、約4億配列、合計約0.1兆アミノ酸残基を含んでいる(Microbiome Datahub protein sequence dataset 2026)。
引用
PZLAST-MAG: full length protein sequence similarity search server of large-scale MAG proteins
Koichi Higashi , Hitoshi Ishikawa , Ken Kurokawa , Hiroshi Mori
Bioinformatics Advances, Volume 6, Issue 1, 2026
関連
