完全長配列が決定され、注釈・カタログ化される細菌プラスミドの数が増加したことにより、プラスミドを比較・分類する計算ツールの開発が促されている。既存の手法は、全長DNA配列(Mash、BLASTnなど)または翻訳されたオープンリーディングフレーム(ORF)(BLASTp、DIAMONDなど)を比較するのが一般的であり、プラスミドレベルのスコアはORF間の類似性を集約して得られる。しかし、これらの手法は近縁なプラスミドに限定されるか、大規模解析では計算量が大きくなる。本研究では、ORF間の類似性と遺伝子近傍の保存性の両方を捉えるword2vec表現を用いて構築したプラスミド検索ツール、pLAST(plasmid Language Analysis and Search Tool)を開発した。ベンチマークの結果、pLASTは機能的に類似したプラスミドの同定において、DNAベースおよびORFベースの手法を上回った。また、広く用いられているMashと比較して、共有された接合対形成(MPF)系、リラクサーゼ、oriT型の検出性能が、それぞれ37%、30%、13%向上した。この性能は数千配列からなるデータセットにも拡張可能であり、約56,000個のプラスミドを対象としたクラスタリング解析では、予想される機能グループが明らかになった。全体的な類似性に加えて、pLASTは、ウェブサーバー(https://plast.lbs.cent.uw.edu.pl/)として無償で利用できるほか、カスタマイズした解析を行うために、Pythonモジュールおよび事前計算済みデータベースとしても https://github.com/labstructbioinf/pLAST で提供されている。
Documentation
https://labstructbioinf.github.io/pLAST/index.html
webサービス
HP
https://plast.lbs.cent.uw.edu.pl/
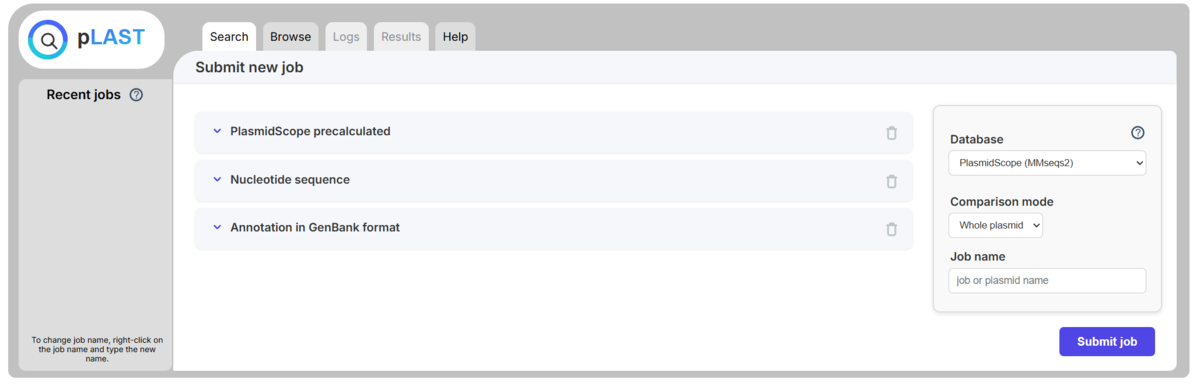
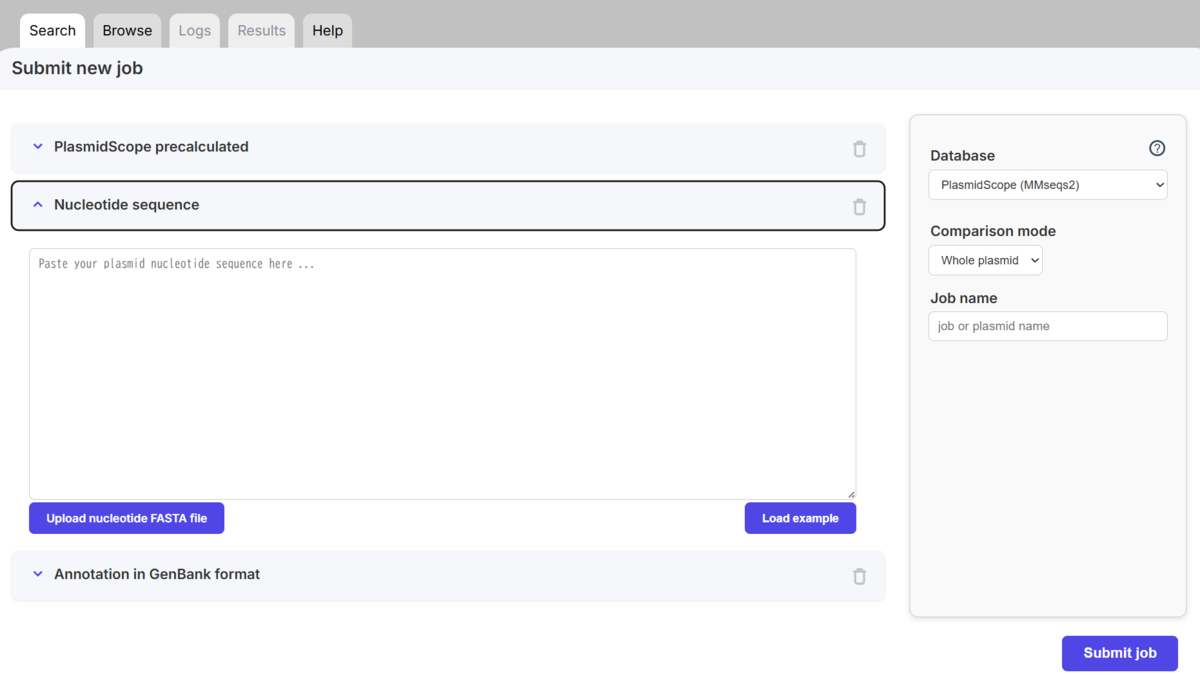
クエリは塩基配列やGenbankフォーマットとして指定する。
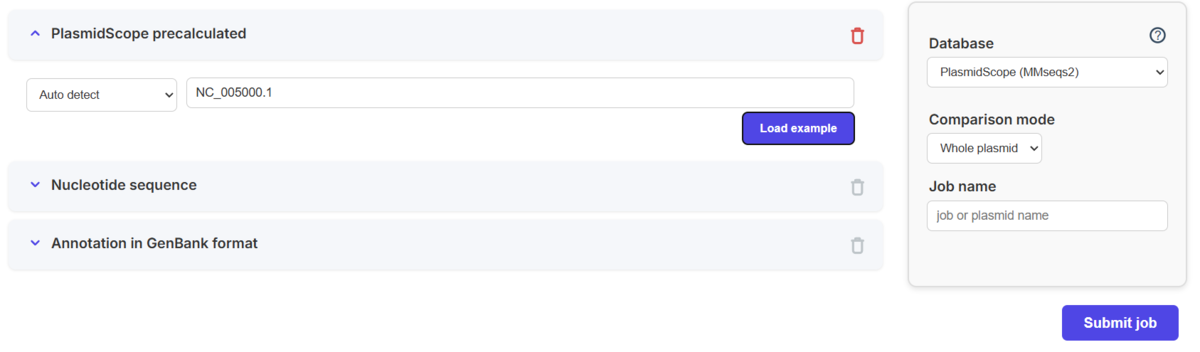
あるいは事前計算済みでデータベースに収録されているプラスミドを呼び出すことができる。Load exampleから指定した。
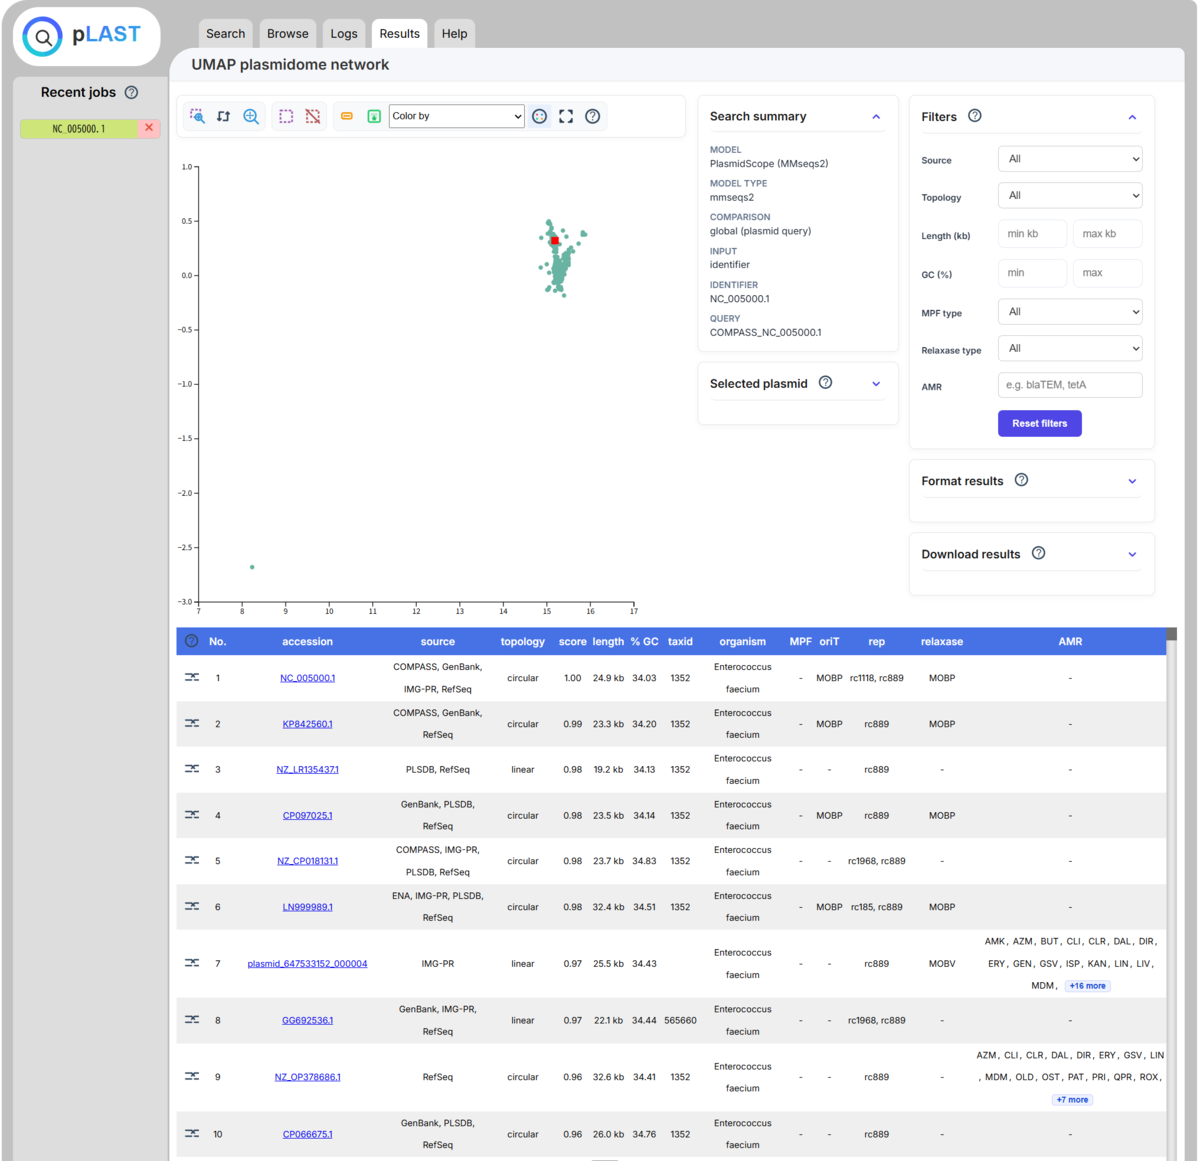
出力例
各プラスミドのembeddingがUMAPにより2次元に圧縮してプロットされる。類似したプラスミド同士ほど近くに配置されている。
pLASTは、PlasmidScope に含まれる約75万本のプラスミドについて、ORFをMMseqs2でprotein familyにクラスタリングし、各プラスミドをprotein familyをword、plasmid上のORF列をsentenceとして扱ってword2vecを学習している。約1,060万のユニークなタンパク質配列から約200万のMMseqs2 clusterを作り、word2vecでは64次元のベクトルを学習している。最終的には、プラスミドを構成するORFのembeddingを平均して1本のplasmid embeddingを作り、そのベクトル同士のコサイン類似度で順位付けしたり、UMAPクラスタリングしている。
赤い四角がqueryで、青緑色の点がPlasmidScope中のプラスミド。queryはPlasmidScopeの中のよく似たembeddingを持つプラスミド群の中に位置している。
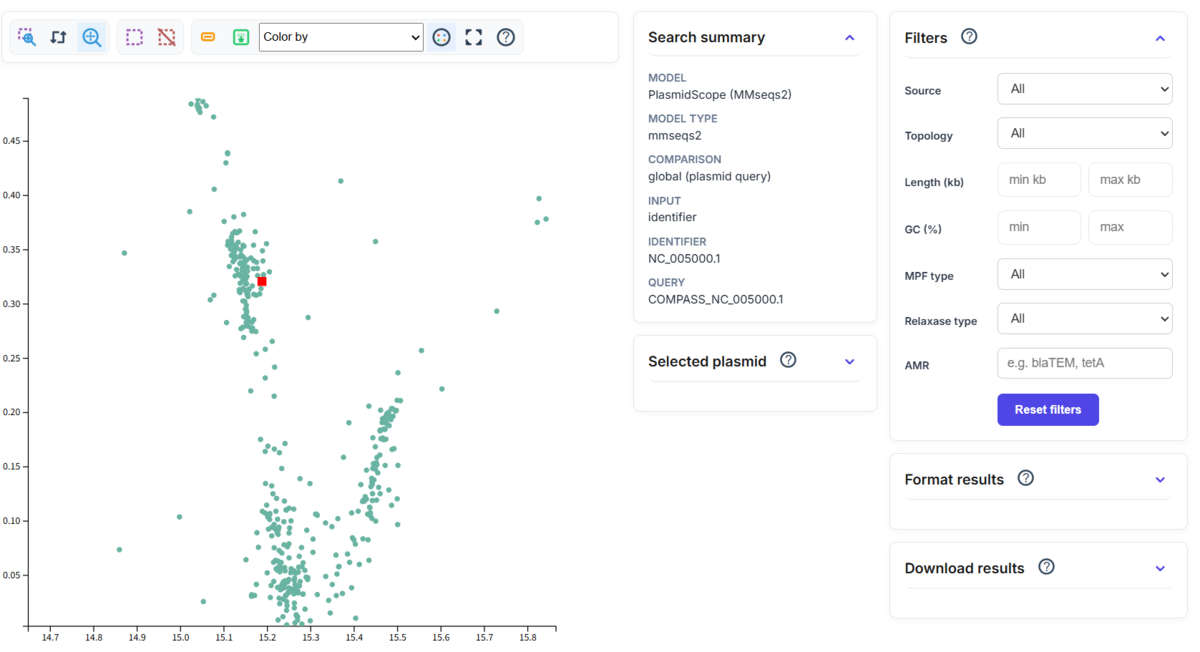
ソースをAllからPLSDBに変更した。
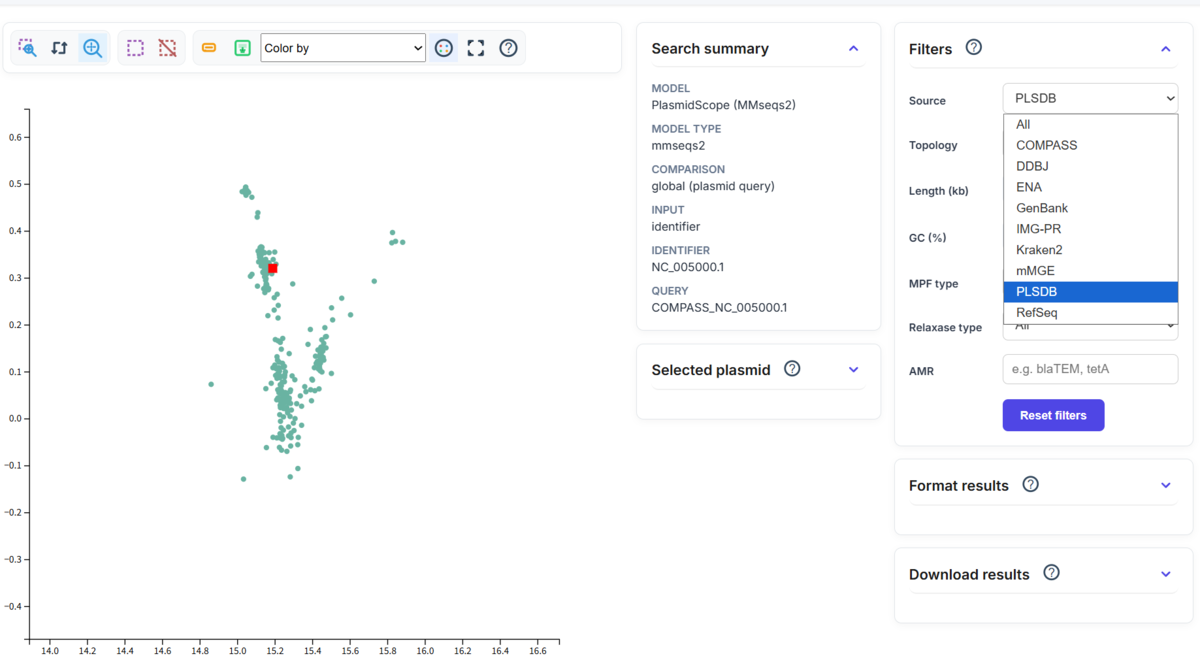
色付けをMOB suiteに変更した。ほかにtopology (circular/linear)、GC、pLASTスコアがある。
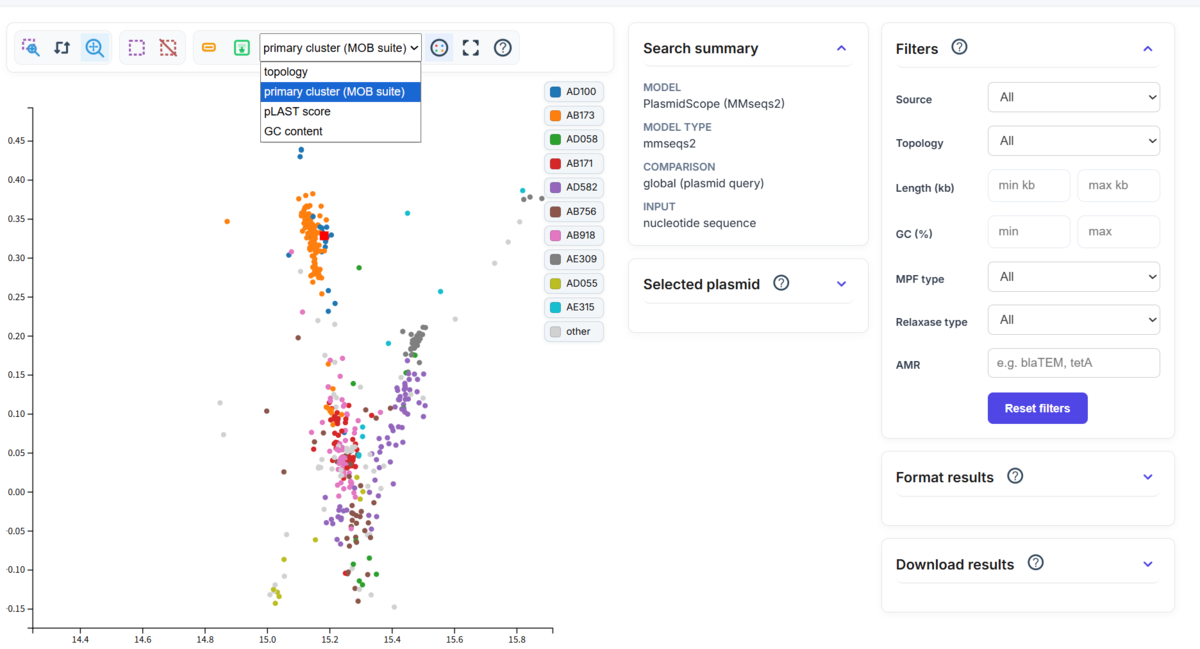
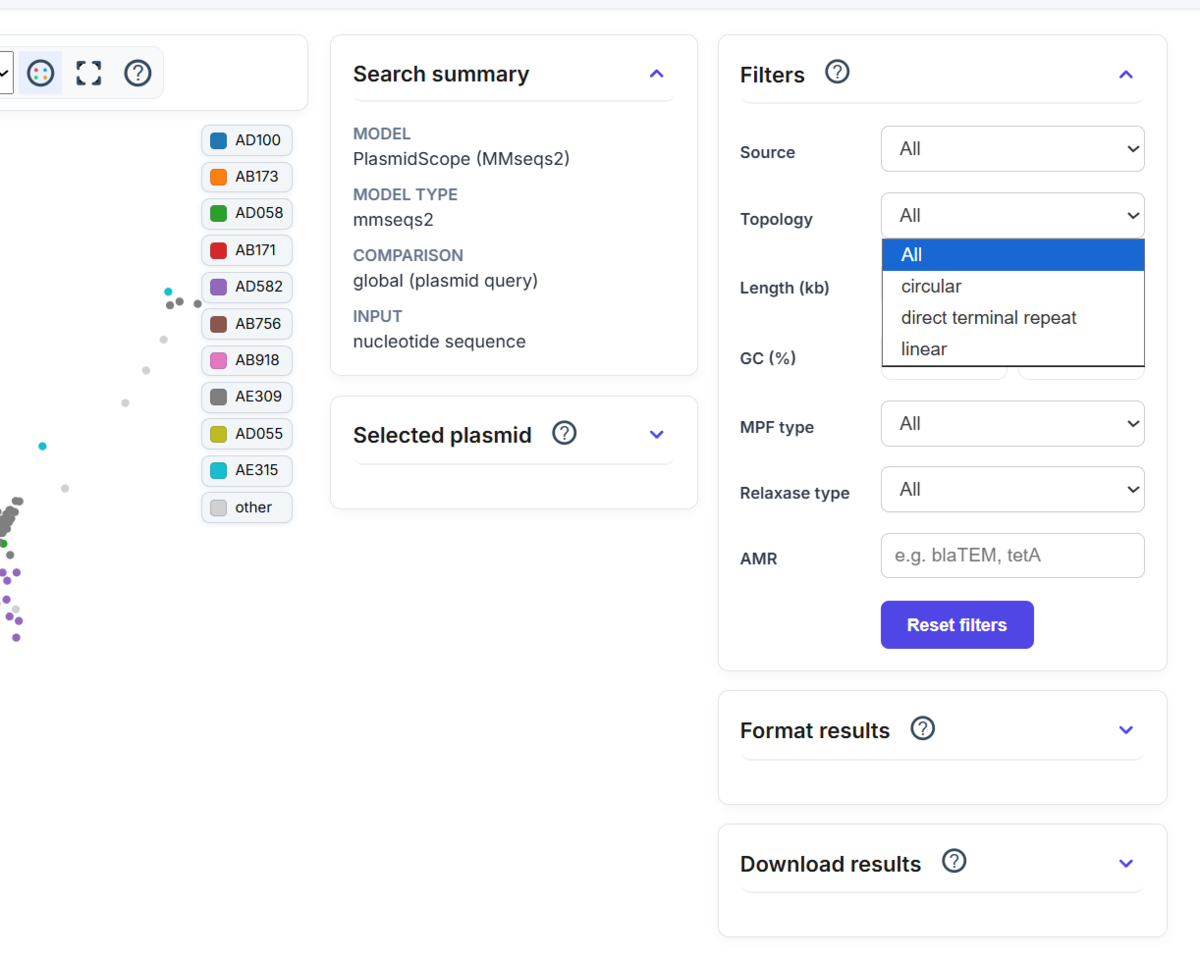
右の表から、様々な条件でフィルタリングできる。
下の表には、queryと類似しているプラスミドがスコアの高い順に表示される。accession 、source、topology (circular/linear)、length、%GCの列が表示されている。organismはホスト、MPF・oriT・rep・relaxase はそれぞれ接合伝達・複製に関するタイプ、AMR は薬剤耐性遺伝子の情報を示す。
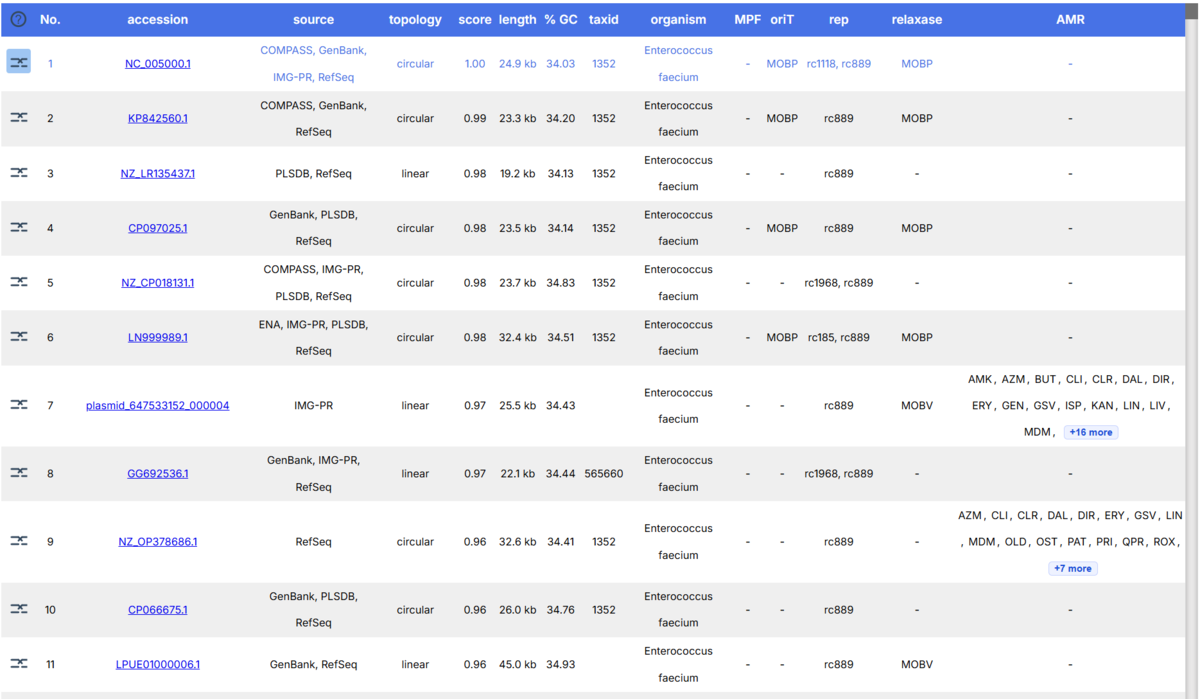
scoreが1に近いほどqueryと類似している。ただし、これは塩基配列同一性ではなく、protein familyの構成と、その周辺にどの遺伝子が並ぶかを反映したembedding同士のコサイン類似度を意味している。この画像では、上位にEnterococcus faecium由来のプラスミドが多く、共通するreplicon typeも頻繁に見られるが、長さは2倍程度差があり、AMR遺伝子の有無でもかなりばらついている。似たplasmid backboneを持ちながら一部の機能モジュールが異なるプラスミド群を拾っていることが分かる。つまり、高いスコアがそのまま対応するORFのアミノ酸配列同一性が最も高いプラスミドという意味ではない (0.99は99%同一という意味ではなく、pLASTが学習したプラスミドの機能的・遺伝子構成的な表現空間で非常によく似ているという意味)。
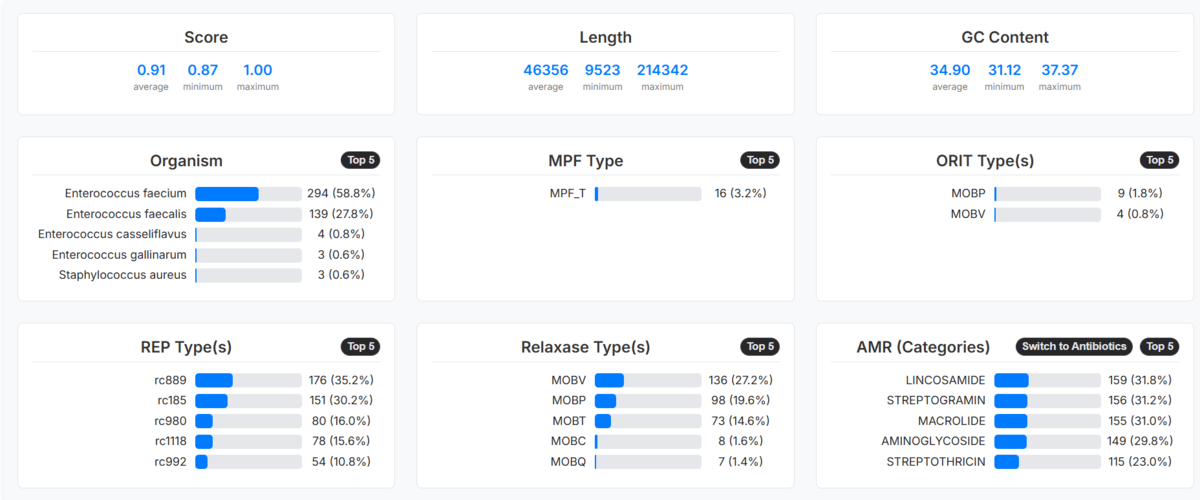
下にはサマリーが表示される。
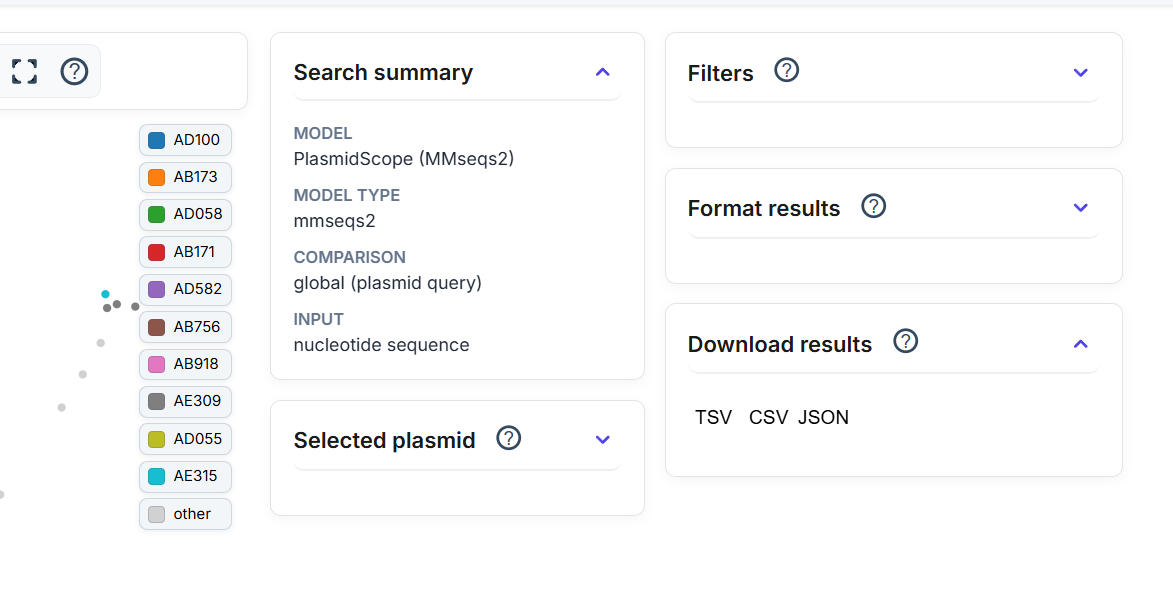
結果はTSV、CSVやJSONとしてダウンロードできる。
ローカルマシンへのインストール
WSLで環境を作って試した。
- pLAST requires Python version 3.9 to 3.12.
mamba create -n plast -c conda-forge -c bioconda python=3.12.0 pip=25.3 hmmer=3.4 mmseqs2 prodigal -y
conda activate plast
python -m pip install plast
データベース
事前計算データをダウンロードして展開する。数GBある。
mkdir data
wget -O data/data.tar.gz https://ndownloader.figshare.com/files/66111080 \
  --user-agent="Mozilla/5.0"
tar -xzf data/data.tar.gz -C .
rm data/data.tar.gz
data/
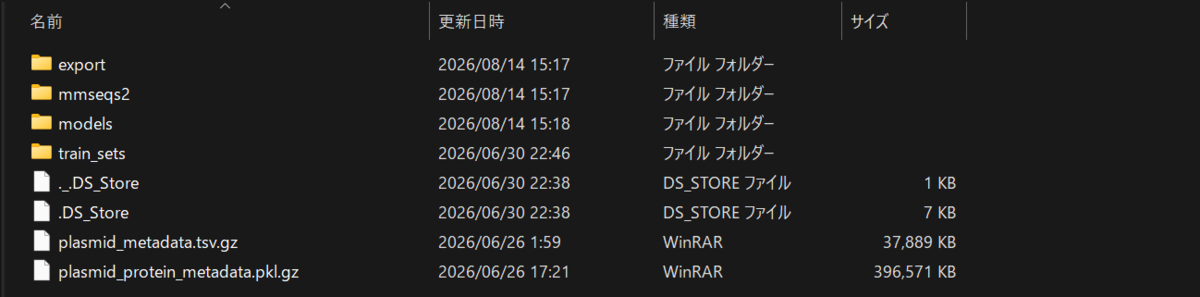
MMseqs2モデル、検索用データベース、メタデータが含まれる。eggNOGモデルを使う場合は追加HMMデータベースも必要になる。こここではDBに含まれるMMseqs2モデルを使う。
実行方法
公式リポジトリにあるサンプル配列を取得する。
git clone https://github.com/labstructbioinf/pLAST.git
cd pLAST
wget -O NC_005000.1.fasta https://raw.githubusercontent.com/labstructbioinf/pLAST/main/notebooks/examples/NC_005000.1.fasta
PythonからpLASTを実行する。実際のテストでは、以下の処理で24,873 bpの配列から34個の特徴を注釈し、34個のMMseqs2クラスタを割り当て、上位10件をTSVに保存した。
cat > run_plast.py <<'PY'
from pathlib import Path
import pandas as pd
from plast.data import PLASTData
from plast.plast import PLAST
from examples.configuration import config

root = Path.cwd()
data = PLASTData(config)
plast = PLAST(data=data, model="mmseqs2_model")
plast = plast.load_nt_fasta((root / "NC_005000.1.fasta").read_text())
print(f"length={plast.length}; annotated_features={len(plast.parsed)}")
plast = plast.assign_mmseqs_clusters(use_gpu=False, threads=4)
print(f"assigned_clusters={len(plast.vector)}")
plast = plast.encode()
results = plast.get_most_similar(maxret=10)
df = pd.DataFrame.from_dict(results, orient="index")
df.index.name = "query_match"
df.reset_index().to_csv("pLAST_NC_005000.1_results.tsv", sep="\t", index=False)
print(df"pLAST_distance", "length", "gc", "organism", "predicted_mobility".head())
PY

PYTHONPATH=notebooks python run_plast.py
探索には1分くらいかかった。
出力例
length=24873; annotated_features=34
assigned_clusters=34
COMPASS_NC_005000.1 0.984177 24873 ... Enterococcus faecium mobilizable
GenBank_GG692536.1 0.978578 22101 ... Enterococcus faecium non-mobilizable
COMPASS_NZ_CP018131.1 0.975886 23736 ... Enterococcus faecium non-mobilizable
出力されたTSVには、類似度に相当するpLAST_distance、配列長、GC含量、分類群、複製型、AMR情報、リラクサーゼ型、oriT型、予測移動性などが含まれる。web版と同じだが、大規模探索にはローカル版が向いている。
その他、論文より
-
プラスミドに特化したデータベースは急速に拡大している。PLSDBデータベースに収録される非冗長エントリ数は、2021年の約34,000件から、2025年の更新版では約72,000件へと増加した(Molano et al. 2025)。重複除去を行っていないリソースにはさらに多くの配列が収録されており、IMG/PRおよびPlasmidScopeデータベースには、それぞれ約70万および約85万2,000のプラスミド配列が収録されている。これらには、メタゲノムから再構築されたプラスミドも含まれる(Camargo et al. 2024, Li et al. 2025)。
-
これらのリソースを検索する際には、クエリとなるプラスミドとデータベース内のエントリを比較するツールが用いられる。一般的な選択肢としては、Mash(Ondov et al. 2016)、BLASTn(Altschul et al. 1990)、あるいはskani(Shaw and Yu 2023)やfastANI(Jain et al. 2018)のようなAverage Nucleotide Identity(ANI)法などのDNAベースの手法に加えて、DIAMOND(Buchfink, Xie, and Huson 2015)のようなツールが返すORF間の類似性を利用したタンパク質ベースのアプローチがある。
-
ORFベースのフレームワークでは、ORF間のヒットを集約することで、遺伝子構成の比較やモジュールの検出を行う(Suzuki, Doi, and Arakawa 2020, Teixeira et al. 2023)。このほか、COPLA(Redondo-Salvo et al. 2021)、mge-cluster(Arredondo-Alonso et al. 2023)、pling(Frolova et al. 2024)のように、クエリプラスミドに対する類似性によってデータベース内のエントリを順位付けすることよりも、主としてプラスミドのタイピング、クラスタリング、あるいは再編成を考慮した関係性の解析に重点を置いた手法も存在する。
-
skani、fastANI、Mash、BLASTnをプラスミド比較に適用する場合、いくつかの重要な制約がある。第一に、これらはDNA配列を対象とするが、DNA配列はタンパク質配列よりも速く分岐するため、遠縁な関係では相同性のシグナルがしばしば検出限界を下回る。第二に、プラスミドはモジュール性を持ち、しばしばモザイク状の構造をとるため、共有される配列領域が不連続であることが多く、アクセサリー領域や可動性遺伝因子が全体的な類似性の尺度を歪める可能性がある(Redondo-Salvo et al. 2020)。第三に、配列アラインメントに依存する手法(例えばBLASTn)は、配列の環状性を明示的に考慮しない場合があり、その結果、本来は非常によく似ているプラスミド同士であっても、場合によっては類似性の推定値が低下することがある。
-
ORFベースの手法は一般に、遠縁な相同性を検出するうえでより頑健である。この種のアプローチの中でも、プロファイルHMMは、特定のタンパク質ファミリーを対象としたアノテーションにおいて高い感度を発揮するが、計算コストが高い。DIAMONDのような、より高速ではあるものの感度の低い手法を用いれば、より広範な検索が可能になる。しかし、PlasmidScopeほどの規模のデータベースに対して全ORF対全ORFの比較を行う場合、それでもなお相当な計算コストを要する。
-
さらに、独立したORF間比較を集約する従来の手法では、結果は配列の回転や遺伝子順序の影響をほとんど受けない一方で、遺伝子順序を無視すると、進化的に有用な情報であるシンテニーが失われるという欠点がある。さらに、ゲノム上のコンテキストを考慮しないタンパク質レベルのマッチは、特に最近の遺伝子重複によって生じたパラログによって混乱する可能性がある(Maida et al. 2014)。
本研究では、pLASTを紹介する。pLASTは、もともと自然言語処理のために開発されたword2vecモデルを、プラスミドを「単語(タンパク質ファミリー)」からなる「文」として扱うことで適用する。この方法により、局所的な遺伝子近傍関係を学習し、生物学的・機能的に意味のあるデータベース検索と、大規模データにも対応可能なクラスタリングを実現する。
- プラスミドはモザイク状で、accessory geneやmobile elementの挿入・欠失が多いため、全配列をそのまま比較すると関係が見えにくくなる。pLASTは、DNA配列の単純な距離やORFの個別相同性だけでなく、ORFの構成と近傍関係をまとめてプラスミド表現にする。大規模なプラスミドデータセットを機能的なグループに分けたい場合や、共有された移動性関連モジュールを探したい場合に向いている。
引用
pLAST: a tool for rapid comparison and classification of bacterial plasmid sequences.
Krakowski K, Orlowska M, Kaminski K, Bartosik D, Dunin-Horkawicz S.
Bioinformatics. Published: 29 July 2026
関連
