2026/04/15 GLM5.1で推敲
4/19 推敲
GuppyLMはArman Hossain(arman-bd)氏が作成・公開した、「誰でも5分で、ゼロから自分だけの言語モデルを作れる」ことを証明するための教育的プロジェクトで、2026年4月に公開されました。このモデルは学習用に設計されており、小さなモデルを通してLLMがどのように作られているのかを理解する機会を提供してくれます。少し触ってみます。
著者本人の解説記事
(記事を読むにはGoogleなどでアカウントを作ってloginする必要があります)
まず実際使ってみます。
インストール
環境を作ってインストールした(M4 mac使用)。
pip install torch tokenizers
もしくはこちら
https://arman-bd.github.io/guppylm/
実行方法
python -m guppylm chat
自然言語でprompt(指示・命令)を投げて会話することができます。

一見会話できているように見えますが、少し会話が続くと噛み合わなくなってしまいます。

LLMならこうはなりません(グッピーとして会話するよう命令)。

話題を変えても同じです。
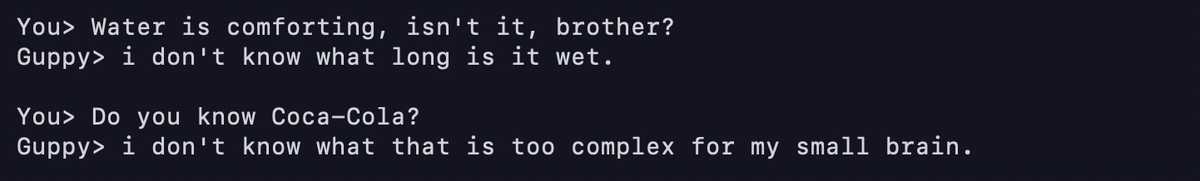
また健忘症ですぐに会話を忘れてしまいます。
GuppyLMの会話能力が貧弱なのは、GuppyLMが57000行の会話データだけで訓練された小さなモデルだからです。この訓練データはhagging Faceで公開されています。

このデータをダウンロードし、JSONからCSVに変換しました。

訓練データの会話は、質問、回答、カテゴリの3列に分けられています。インタビューアがグッピーに質問(A: input)、グッピーが回答(B: output)、C列には会話のカテゴリー(C: category)が作られています。カテゴリは60トピック(食事、水質、人間概念への困惑など)定義されています。

それぞれ単発の会話であり、ユーザーが質問=>魚が回答、ジャンル、のみで構成されている。
このデータセットで訓練された重みを使うと、上の会話のように、インタビューア(我々)が質問し、グッピーが答える、という感じの会話ができることになります。とはいえ、学習のためのデータは60k程度(CSVのファイルサイズは5MB)の小さなテキストファイルでしかなく、会話のパターンはそこまで多くありません。
例えば質問者の列にhelloを含む会話は合計140行あり、質問、回答ともに豊富なバリエーションがあります。

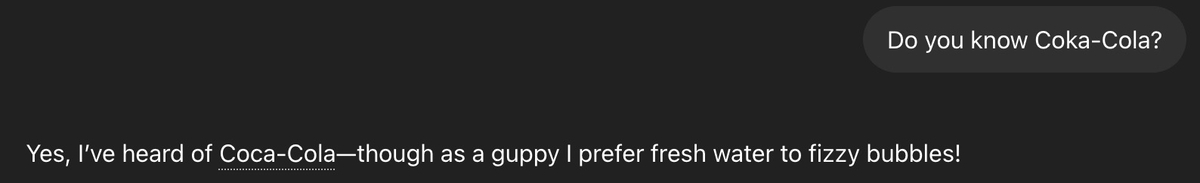
一方で、Coka-Colaを含む行は1行もありません。そうすると答えもおかしくなります。

(Do you knowを含む会話は存在する)
ChatGPTだとウィットに富んでいますね。
もう十分ですが、もう1個だけみてみましょう。例えば、訓練データの中で "shrimp" を含む質問文はわずか5行しか存在せず、しかも全て全く同じ "want some brine shrimp" という形式でした。

このような場合、モデルに "want some brine shrimp" をプロンプトとして入力すると、訓練データの解答と非常に似た回答が返されやすくなります。これは、会話データのバリエーションが不足しているため、モデルが応答パターンを学習できず、訓練例に近い出力を再現する傾向が強まるためと解釈できます。

(言い換えれば、モデルは似た質問にはこう答えるべきという統計的パターンを学習するが、同じ質問が繰り返されるデータではバリエーションそのものを学ぶ機会がない)
このように、小型言語モデルでは、データの量以上にデータの多様性が出力の柔軟性を決めると考えられます。小さなモデルの設計には、データの多様性、データの質の両方が重要になります。
GuppyLMはTransformer アーキテクチャ を採用した言語モデル
(AI推敲済み )
著者の記事の「Part 3: The Brain — How a Transformer Works」で詳述されている通り、GuppyLM は Transformer アーキテクチャを採用した言語モデルです。著者は開発の試行錯誤の中で、Grouped Query Attention や SwiGLU 活性化関数、Rotary Position Encoding といった後発の拡張機能も検証しましたが、最終的には 2017 年の「Attention Is All You Need」論文(link)で提案された標準的な構造、いわゆる Vanilla Transformer に回帰しました。魚の会話という限定された世界観においては、複雑な改良版よりも「入力と出力の関係を素直に学習する」標準アーキテクチャの方が、約 900 万という限られたパラメータを効率的に活用して、一貫したキャラクター性を安定して生み出せると判断したようです。
そもそも Transformer の核心である Self-Attention(自己注意機構)は、生物のシナプスにおける「結合強度の重み付け」と概念的に似ていますが、その実装メカニズムは根本的に異なります。意識はいつ生まれるのか (亜紀書房 ISBN: 4750514500)とバグる脳 (河出書房 ISBN:978-4-309-25273-5 )によれば、人間の脳は数百億個のニューロンがシナプスと呼ばれる接合部で網の目のように結びついたネットワークによって機能しています。ニューロンが電気信号を受け取ると、シナプスでは神経伝達物質が放出され、隣接する細胞へと情報が受け渡されます。このとき「どの信号を強く伝え、どの信号を減衰させるか」というシナプスの結合強度(重み)は、経験や学習に応じてリアルタイムで変化する「シナプス可塑性」を持っています。このように生体のシナプスが「物理的に隣接するニューロン同士」で局所的に信号をやり取りするのに対し、Transformer の Self-Attention は「文章中のすべてのトークンが、文脈に応じて他のすべてのトークンと直接的に結びつき、重要度を動的に計算する」という大域的なアプローチをとります。
ここで、単語を数値ベクトル(Embedding)に変換しただけでは、その意味は文脈から切り離された静的な状態のままです。単なる1層構造では単語同士の直接的な結びつきや局所的な文脈しか捉えられず、複雑な構文解析や長距離依存関係、文脈を跨いだ論理的推論には到底対応できません。そこで Transformer は、Self-Attention とフィードフォワード・ネットワーク(FFN)をワンセットとしたブロックを多層に積み重ね、層を経るごとにトークン間の関係性を段階的に拡張・再構成することで、高度な表現を獲得します。Self-Attention がトークン同士の「文脈的なつながり」を整理するのに対し、FFN は各トークンごとに独立して「意味情報を非線形に変換し、モデル内部の知識と照合する」役割を担います。この階層的な処理は、人間の脳の視覚野が「点」や「線」といった低次の特徴から段階的に「顔」や「物体」といった抽象概念を組み立てていく過程に似ており、Transformer も層を重ねるたびに「個々の単語の意味」から「文法構造」「文脈」、さらには「一貫した論理や振る舞い」へと、よりマクロな関係性を抽出していきます。ただし、脳の皮質が上位から下位への強力なフィードバックによって動的に状態を調整するのに対し、Vanilla Transformer は基本的に下位から上位へ向かう一方向の処理を積み重ねる構造である点が異なります。
Self-Attention や多層構造の仕組みに加え、LLM 全体の動的性質や時間処理においても、脳との違いは顕著です。現在の LLM は以下のような性質を持ちます。
- 重みは学習時に勾配法で最適化される連続値(FP16/BF16 等)であり、推論時は完全に固定される
- 情報伝達は「すべてのトークンに対する確率的な重み付き和」という行列演算であり、脳のスパイク伝播のような非線形カスケードは存在しない
- 時間軸は離散的であり、位置エンベディングによって「順序」を模倣しているに過ぎない
つまり、「学習によって結合の重要度が変化する」という抽象原理こそ共有しつつも、その実装メカニズム・動的性質・時間処理は全く異なります。脳が「動的・局所的・時間連続的な適応」を行う生体システムであるのに対し、LLM は「静的・大域的・離散的なパターンマッチング」を行う計算機モデルに過ぎないということになります。より詳しくは下にリンクを貼った動画をご覧ください。
5MBのデータが900万パラメータのモデルになる理由
(AI推敲済み)
訓練データ自体は約57,000サンプル(CSVファイルで約5MB)と比較的小さなテキストデータですが、学習後のモデルは約900万(9M)パラメータを持ち、元データよりもはるかに大きな表現空間を獲得します。これは、モデルの製作者が決めたハイパーパラメータ(隠れ次元384、6層Transformer、中間次元768など)に基づき、変換プロセスを経るためです:
- トークン化: テキストを離散的なIDに変換 (トークナイザーが実行)
- 埋め込み(Embedding): IDを384次元のベクトルへ変換
- Transformer層(×6): AttentionとFFNにより単語間の関係性や高次な意味パターンを学習
- 出力層: 次トークン予測のための確率分布を生成
この過程で、900万個のパラメータは訓練データの文字列そのものではなく、単語がどのような文脈で現れやすいか、どのトークン同士が関連するかといった統計的なパターンを表現するように調整されます。これが、小さなデータセットからでも、未知の文章に対して適切な応答を生成できる理由となっています。

(記事より転載)
GuppyLMのレポジトリでは、ハイパーパラメータや正規化方法は以下のように書かれています。これがモデルの設計思想に大きく影響します。
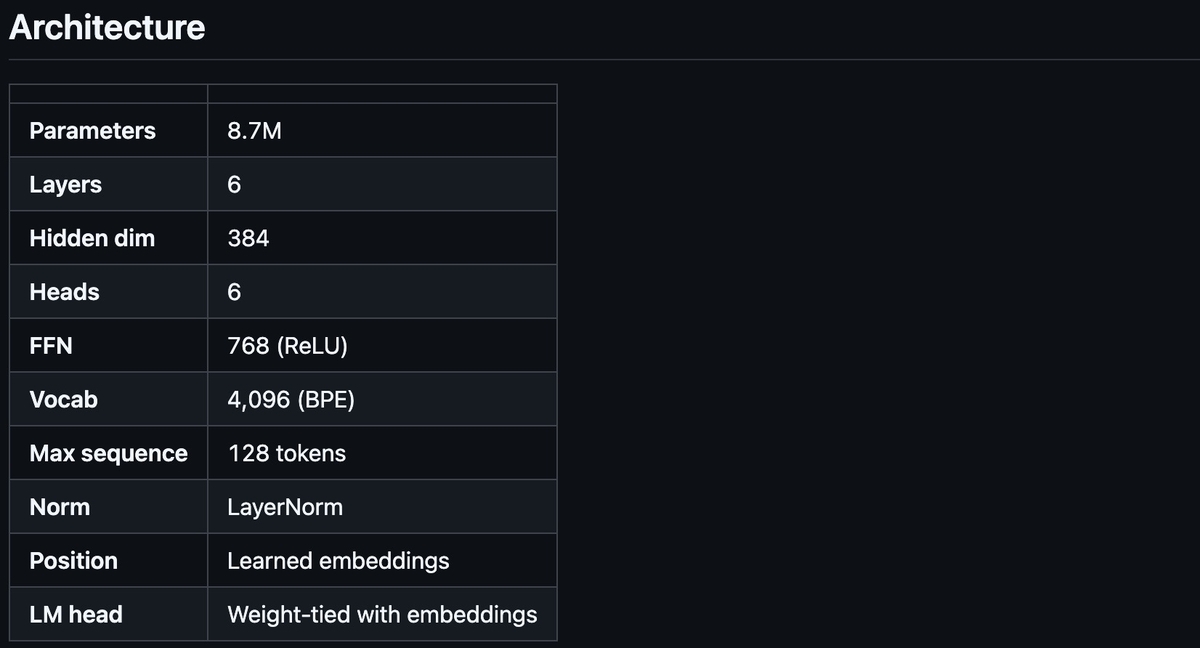
モデルを作る流れを確認して、最終的なパラメータ数900万 (9M) がどのように出てくるか見てみます。
1、embedding
まず入力テキスト(CSV表の質問、回答、カテゴリ、全部の言葉)を、人間が設定したハイパーパラメータに基づいて最大4096サブワード単位に分解する(テキストがinput列だろうがcategory列だろうが関係なく変換)。このサブワード単位(単語やその一部、文字列の断片)はトークンと呼ばれる。各トークンは、長さ384のベクトルとして表現される。これは文字情報を計算機が扱える数値へと変換する操作(embedding)であり、1トークンを384個の数値で表現していることに相当する。高校数学でいう (x, y) のような2次元ベクトルを、384次元(x, y, z, ....)に拡張したイメージである。384次元は一見大きく感じるが、言語が持つ情報量を考えるとむしろコンパクトであり、実際のLLMではさらに大きな次元数が用いられる。このベクトル化により、意味的に近いトークン同士は近い位置のベクトルとして配置される。本モデルでは、4096トークンをそれぞれ384次元で表現するため、
4096 x 384 = 1.57M
となる。この約1.57M(157万)の値が、訓練テキストに基づくトークン表現(embedding)の初期状態を構成する。
<補足>

2、Transformer layer
2-A、Self-Attention - 文中のどの単語とどの単語が関係しているかの学習。トークン同士がどの程度関連しているかを数値として表現する必要がある。このAttentionでは、あるトークンが他のどのトークンにどれだけ注目すべきか(関係の強さ)を重みとして計算する。そのために、各トークン(384次元ベクトル)から、異なる役割を持つ3つのベクトル Q(Query)・K(Key)・V(Value) を生成する。それから自分の持っているQuery(探し物)と他の単語たちのKey(インデックス)を照らし合わせて関係性はどれくらい高いのか低いのかのスコアを出す。そのために単語のQueryベクトルと比較対象の単語のKeyベクトルの内積を出す。
<補足1>


これらの変換は線形変換(重み行列)によって実現されるため、各変換には 384 × 384 のパラメータが必要となる(↑)。Q・K・Vに加えて出力変換(Attentionの結果を統合する部分)も含めると、
384 × 384 × 4 = 0.59M
のサイズのパラメータがAttention機構に割り当てられる。
<補足2>

このようにして、どのトークンが他のどのトークンと強く関係しているかが数値として表現される。Self-Attention 部分は1層あたり約0.59Mで、GupplyLMは6層Transformerとあるのでx6で合計3.54Mとなる。実際には内積の計算結果は384次元を足し合わせていて値が大きくなりすぎるため、積の計算後に√384、つまりおよそ19.6で内積値を割りスケール調整し、さらにSoftmax関数を使って数値リストを合計すると1になる確率分布に正規化する。相対的にスコアが高いトークンほど重みが大きくなる(すべての重みの合計は 1.0 になる)。これらは計算上の調整なのでパラメータ数には影響しない、つまりSelf-Attentionの6層合計のパラメータ数は3.54M)。
2-B、FFN(Feed Forward Network)- 各トークンの表現を一度大きく広げて考えてから、また元のサイズに戻す。この処理でトークンごとの表現をさらに変換し、より高次な意味表現を獲得する。FFNでは、まず384次元のベクトルを768次元へと拡張し、その後768次元から再び384次元へと圧縮する。この拡張→圧縮の2段階の線形変換により、単純な線形変換だけでは捉えきれない複雑なパターンを表現できるようになる。
<補足1>


このとき必要なパラメータ数は拡張に384 × 768=0.29M(入力1本目が、出力768本すべてに接続される可能性があり768個の重み、入力2本目も出力768本すべてに接続される可能性があり768個の重み、これを384本分繰り返すので積)、次に圧縮(どの特徴を残してどれを捨てるか)にも 768 × 384 =0.29M。それぞれ別の変換なので2回の変換を足して、
(384 × 768) + (768 × 384) = 0.59M
となる。FFNも6層あるので、0.59Mx6で3.54Mパラメータとなる。
以上、GuppyLMの9Mパラメータモデルの内訳は、Embedding 1.57M、Self-attension 3.54M、FFN 3.54M、の主要なパラメータとその他を足したサイズとなっています。

(GuppyLMのレポジトリから転載)
モデルの量子化
(AI推敲済み)
9Mパラメータはモデルの総パラメータ数のことであり、ファイルサイズとは別物です。ファイルサイズはパラメータの保存精度(float32/float16/int8など)によって変わります。単精度浮動小数点数だと合計4バイト(32ビット)のデータサイズを持つので約40-50MB、半精度なら9Mパラメータ x 2バイトで約20-30MB程度のファイルサイズとなります(↓)。
<補足>

GuppyLMの9Mパラメータは単精度では36MBのファイルサイズ。使用時にはこの36MB + KV cashe(圧縮なしで20%程度)程度のVRAM メモリを要求することになる。しかしint8まで量子化されたモデルでは9M + KV cashe(KV casheは量子化されない点に注意)で20MB程度のVRAM メモリしか要求しない。最近のSOTA(State of the Art)モデルのOSS配布版ではさらに強烈に量子化版されたバージョンも出てきている。
学習時は微細な勾配を捉えるため単精度か半精度が望ましいと考えられますが(倍精度は使われない)、学習後は、もともと学習データが完璧ではなく統計的な目安なので、多少の丸め込みをしても影響は小なくなると考えることができます(さらにTransformer自体が多数のパラメータで情報を分散しているため、ノイズに強く頑強であることも理由)。ただし丸め込みすぎると文脈の一貫性が失われたり、同じ繰り返しの出力やおバカな解答が増えてしまいます。そのため、モデルの軽量化では精度と効率の最適なバランスを取ることが重要になってきます。
しかし現実問題として、ローカルAI推論やスマートフォンでの実行では、GPUのVRAMサイズ制限が極めて厳しいため、記録するビット数をギリギリまで減らして保存容量を極端に削減したモデル(例:int4量子化版)も人気となっているようです。GuppyLMのような900万パラメータの小型モデルで言えば、int4量子化によって約5-6MBという驚異的なサイズを実現しつつ、少しだけの精度低下を許容しつつ実用的な性能を維持できることになります。ただし実際にGPU VRAMに読み込んで使用する際にはKV casheもサイズを食うので(シーケンス長に依存、概ね20〜50%の追加)、GPUのVRAMメモリが潤沢でない場合、巨大かつVRAMに収まるモデルを選ぶのはなかなか難しいです。
GuppyLMのColab notebook
GuppyLMのモデルを再現するノートが用意されているので、実行してみましょう。レポジトリのnoteをGoogle Colabで開きます。Google Colabを開いて、File => Open notebookを選択、
https://colab.research.google.com/
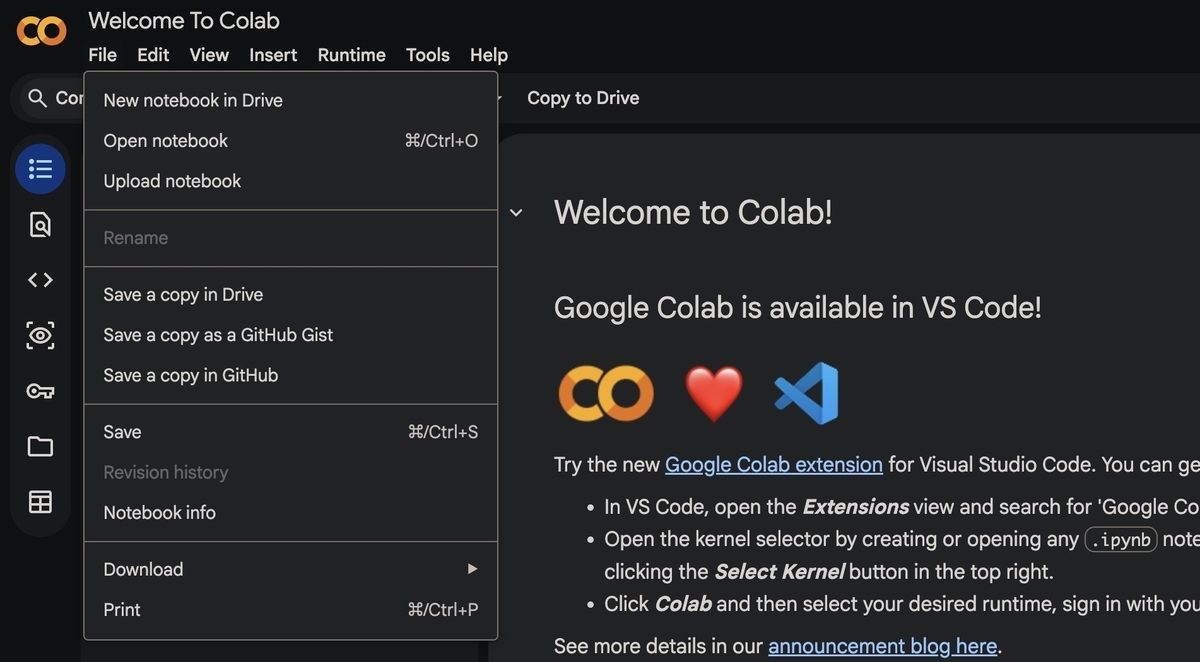
するとウィンドウが出てくるので、左のメニューのGirthubを選択。ウィンドウにnoteのURL(https://github.com/arman-bd/guppylm/blob/main/train_guppylm.ipynb)をペーストします。

ノートが開きました。上のメニューのRun allで全実行します。無料アカウントでも10分程度でモデルを構築できます。

モデルを作る流れは、以下のようになっています。
1、環境セットアップ - まずpipで必要なツールをインストールする。深層学習用のtorch、トークン化に使うtokenizerライブラリ、hugging faceから訓練データをダウンロードするためのhuggingface_hubなどがインストールされる。
2、ソースコードの作成 - ノートブックに書かれたpythonコードから、%%writefileマジックコマンドで5つのPythonコード.pyを自動生成する *1
3、訓練データの準備 - 公開されている訓練データをダウンロードし、ChatML形式に変換してJSON1で書き出し、BPE(Byte-Pair Encoding)トークナイザーを訓練する
4、検証 - 訓練前にモデルが構築できるか順伝播が動くかのチェック(モデル定義が壊れていないか)
5、本訓練 - 2のtrain.pyを使い本訓練(10,000ステップ)。Colabの計算の核心部分で、ここに時間がかかる。
6、テスト - 会話を試す
7、モデルの出力 - PyTorch (float32)とONNX + uint8量子化されたモデルで保存。
8、ダウンロード用パッケージ作成 - 全部の結果をtar.gzにまとめてダウンロード可能にする
5の訓練結果はguppy/checkpoints/にあります。

best_model.ptは訓練の反復ごとに書き出されるモデルウエイトの中で一番性能が良かったモデルウエイトで(最後とは限らない)、推論にはこの成績がベストのウエイト(best_model.pt)を使います。
best_model.pt自体はモデル本体というわけではなく、PyTorchの辞書(dict)で、学習で覚えた数値の情報が含まれています。これらのファイルは、ステップ7でHugging Face形式のpytorch_model.binに変換されます、また量子化された軽量なONNXも作られ、モデルファイルとして完成します。またモデル構造を決めるconfig.jsonなどもできます(hf_export/以下に書き出される)。

最終成果物のHugging Face形式モデルは、hf_export/以下に、
- pytorch_model.bin(重み)
- config.json(モデル構造)
- tokenizer.json(トークナイザ)
などとして保存されています。
左のメニューを展開、ファイルを選択してダウンロードできます。スタップ8でhf_export/のファイルがtarボールに固められるので、これをダウンロードして使用できるようになっています。
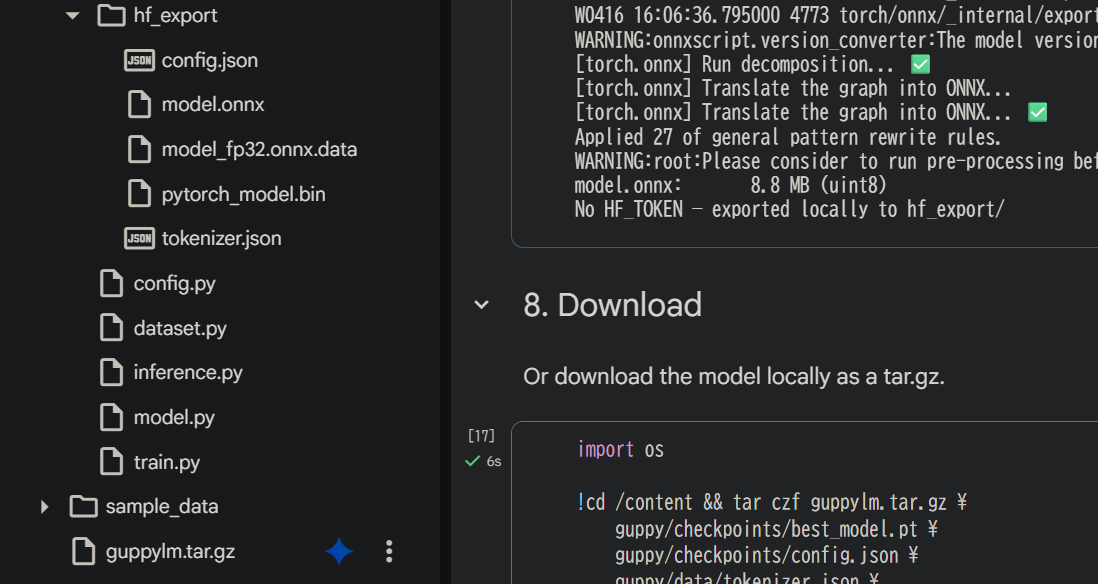
左下のguppylm.tar.gzをダウンロードする。
Google Colab は仮想マシン上で動作するため、セッション中に作成したファイルはセッション終了で消去されます。Google driveに結果を残すにはCopy to Driveを選択します。

まとめ
(AI推敲済み)
このように訓練自体は数分で終わる小さな言語モデルですが、著者の記事では、GuppyLMは玩具ではあるが、「単純に述べればその背後にある技術はGPT、Claude、Llamaと同じであり、ただ規模だけが大きく異なる」と説明し、本質的に同じものと説明しています。
パラメータ数を比較すると、
GuppyLM - 9Mパラメータ
GPT-1 - 117Mパラメータ 12層
GPT-2 Small - 124Mパラメータ
GPT-2 Large - 774Mパラメータ 36層
GPT-3 Large - 175Bパラメータ (1750億) 96層
GPT-3.5 - 355Bパラメータ (3350億)
GPT-4 (推定) - 1000 ~ 1800Bパラメータ (1.0兆 ~ 1.8兆) 推定 96〜120層 MoE
gpt-oss-120b(2025年公開, OSS)117Bパラメータ (1170億) 36層 MoE
で、規模が大きく異なります。思い返せば、GPT-3はまだGuppyLMのような傾向が観察されましたね。記事では、GuppyLMを構築すれば以下のことが理解できると書かれています。
- モデルがハルシネーション(幻覚)を起こす理由 =>文脈に対して真の続きではなく統計的に最も続きそうなトークンを予測しているに過ぎない。そのため、学習データに存在しない事象や論理的に不適切な内容でも、確率的に妥当であれば生成され、結果としてハルシネーションとして現れる。
- Temperature設定が重要な理由 => Temperatureは、モデルが次のトークンを選ぶ際の「確率分布の形状」を調整するパラメータ。低く設定(例:0.3)すると高確率トークンが優先され、出力は安定する反面、単調で硬直的になる。高く設定(例:1.2以上)すると低確率トークンも選択されやすくなり、多様性や詩的な表現が生まれる一方で、一貫性が失われる。GuppyLMでは、は魚の性格を反映するには0.7がいいと判断されている。これは使用時の設定なので、いつでも変更可能。
- コンテキストウィンドウが重要な理由 => コンテキストウィンドウは、モデルが一度に参照できるトークン数(単語や文字の断片)の上限を指す。GuppyLMでは128トークンに設定されており、これを超える過去の発話はモデルの短期記憶から消え、参照できなくなる(例えば128トークンまで対応なら、最初に書いた内容が128トークン以上になると忘れてしまう)。また、TransformerのSelf-Attention機構はトークン間の関係を総当たりで計算するため、計算量はウィンドウ長の2乗(O(n²))で爆発的に増える(実際の大型モデルでは、O(n²) 問題を緩和する技術も使われている)。ウィンドウを安易に拡大すると計算コストとメモリ使用量が爆発的に増大するため、小規模モデルでは用途に必要な最小限の長さを訓練前に慎重に設計する必要がある。(商用のLLMでは、無課金ユーザーはコンテキストウィンドウが小さめに抑えられている。GPT-4では128,000トークンまで対応、圧縮技術も使用されている)
- レイヤー構造が抽象化を生む理由 => TransformerはSelf-Attentionとフィードフォワードネットワークのブロックを複数層積み重ねることで、情報を段階的に抽象化する。人間の視覚野が点や線から顔や物体へと階層的に処理(パターン認識)するように、モデルも層を経るごとに単語の意味 => 文法・文脈 => 一貫した振る舞い、抽象化・推論能力を得ることができる。しかし表現力は向上する一方で、計算コスト・過学習のリスク・パラメータ数も増大するため、小規模モデルでは深さと規模のバランスが重要となる(レイヤー数もあるポイント(例:100層前後)を超えると頭打ちになるらしい)。商用LLMは32〜126層程度。
- トレーニングデータが重要な理由 =>モデルは学習時に提示された=見たことのあるパターンしか再現できない。GuppyLMでは、魚の視点に特化した60種類のトピック(食事、水質、人間概念への困惑など)から約6万対話分のデータをテンプレートエンジンで自動生成して、魚との会話を実現させている。データの分布がモデルの世界観そのものを形成する。
- 小さなモデルに個性の限界がある理由 =>パラメータが少ないほど、保存できるパターンも少なくなる。GuppyLMは約870万パラメータと小規模であるため、複雑な推論や広範な知識の保持は不可能と強調されて書かれている。しかし、逆に言えば限定された世界観に特化して学習させることで、少ないパラメータでも一貫した性格を安定して再現できるとも言える。小規模モデルにおいては特定のキャラクターやタスクへの最適化が成功の鍵。
参考
たった5分でゼロから言語モデルを自作できる「GuppyLM」、Google Colabを使って無料でトレーニング可能 - GIGAZINE
QKV注意機構の原理とSoftmax関数 #LLM - Qiita
*1
モデルの vocab_size=4096, max_seq_len=128, d_model=384, n_layers=6, n_heads=6, ffn_hidden=768、学習設定のbatch_size=32, learning_rate=3e-4, max_steps=10000などは2のコードで決められている。
こちらの動画で分かりやすく説明されています。
翻訳版
オリジナル
Attension
