2026/08/16 追記
AlphaFold3などによるタンパク質複合体構造の正確な予測は、タンパク質間相互作用(PPI)の存在を予測するために利用されてきたが、計算上の負担が大きく、実用性にも疑問があるため、この手法が全ゲノムに適用されたことはなかった。本研究では、pooled-PPI predictionという手法を示す。この手法は、ペアごとの方法と比較してゲノム規模のスクリーニング精度を大幅に向上させると同時に、推論時間を約2倍、ジョブ数を約100分の1に減らすものである。著者らは、わずか2027回のAlphaFold3ジョブを用いて、Mycoplasma genitaliumにおける113,050組すべてのタンパク質間相互作用を予測した。この偏りのない包括的なデータセットは既知の相互作用を高い精度で予測し、AlphaFold3の界面スコアに広く存在する、これまで十分に認識されていなかったサイズバイアスを明らかにした。また、高分子複合体におけるタンパク質間界面を正しく同定し、M. genitalium の新しい生物学も明らかにした。本研究は、pooled-PPI predictionがタンパク質間相互作用を大規模に探索するための拡張性の高い方法であり、機能ゲノミクスの有力な手法であることを示すものである。
インストール
ubuntu22でテストした。
mamba create -n pooled_af3_r -c conda-forge --strict-channel-priority r-base=4.3.3 r-seqinr r-jsonlite r-robustbase git -y
conda activate pooled_af3_r

#本体
git clone https://github.com/horiatodor/pooled-af3.git
cd pooled-af3
実行方法
レポジトリには、1)全タンパク質ペアをカバーするように配列を重複するpoolへ組み合わせるコード (そのまま試すとエラーになったので修正した)、2)作成したpoolを、AF3サーバーにアップロードできるJSONと対応関係を記録するCSVに変換するコード、そして3)AF3サーバーからダウンロードした結果を読み込んでipTMを抽出し、重複結果の整理やサイズ補正を行うコード、が公開されている。総当りでPPIを予測したい配列セットを用意して進める。ここではレポジトリの通り進める。
1、poolの作成
レポジトリのmgen_proteins.txtには、論文で扱ったM. genitaliumの476本のタンパク質配列がfasta形式で入っている。
> head mgen_proteins.txt

これらすべての複合体形成の可能性を通常のAlphaFold3で調べる場合、約11万回の予測が必要となる(前回記事参照)。pooled-AlphaFold3の論文では、各タンパク質をpoolに入れる。このとき、1つのpoolには複数のタンパク質配列を含め、AlphaFold3にまとめて入力する。AlphaFold3がpool内の複数タンパク質を同時に予測すると、各ペアについてipTMなどの相互作用スコアを取得することになる。これを集計して、476種類の全113,050ペアの相互作用を推定している。論文では、この方法で2,027個のpoolを作成し、AlphaFold3 Web Serverで構造推定を実行している。
ちなみに、1つのプール内のペアだけで相互作用を調べても総当りでPPIを調べたことにならないので、同じ配列を複数のpoolに重複して配置している。各poolには複数のタンパク質配列を含め、合計約5,000残基(AlphaFold3の入力tokenのリミット)未満の配列数になるように設計する。pool同士を重複させ、476種類のタンパク質の各ペアが少なくとも1回は1つのpoolに同時に含まれるようにする。AlphaFold3は各pool内の複数タンパク質をまとめて予測し、各ペアについてipTMなどの相互作用スコアを出力する。これらの結果を集計することで、476種類の全113,050ペアの相互作用を推定できる。論文では、この方法により約2,027個のpool予測をAlphaFold3 Web Serverで実行し、約11万回の個別ペア予測を大幅に少ないジョブ数で評価している。
レポジトリには、全体の476配列から、1つのpoolに複数のタンパク質を入れ、各poolの総アミノ酸数が5,000 aa未満になるように配置する関数が示されている。配列は重複して振り分けられ、全タンパク質ペアが少なくともどれか1つのpoolで同時に含まれるように組み合わせられる。生成されたJSONをAF3サーバーへ投入するという流れで進める。
#R
#1 関数をRに読み込む
source("all_by_all_af34_v2.R")

#2 poolの作成
sample_real <- function(x,size,replace=FALSE,prob=NULL){if(length(x)==1)return(x); base::sample(x,size=size,replace=replace,prob=prob)}
proteins <- seqinr::read.fasta("mgen_proteins.txt", forceDNAtolower=FALSE, as.string=TRUE)
pools <- all_by_all(proteins)
pool数の進捗が表示される。

2、JSONファイルへの変換
作成したpoolをAF3サーバーにアップロードできるJSONへ変換する
#R (1の続き)
#3 関数をRに読み込む
source("json_writer_4_8.R")

#4 testフォルダを作成
dir.create("test", showWarnings = FALSE)

#5 作成済みのpoolをAlphaFold3用のジョブに整理する
parsed_jobs <- job_parser(pools1, "mgen", batch_size = 30)

#6 書き出し
write_files(parsed_jobs, "mgen", "test/")
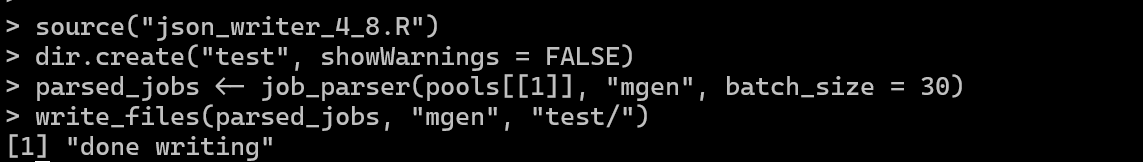
test/には、jsonとcsvファイルが生成される。

=> JSONファイルをAF3サーバーにアップロードし、各poolの予測を実行する。
3、AF3による構造予測
ローカルでするには、ハイエンドGPUが必要。macにも対応しているが、かなり遅いとされている。ここではAF3サーバーを使う。
AF3にアクセスしてログインする。
配列は右上のJSONから登録する。

同時に複数JSONをアップできるが、このコードでは、扱いやすいように、30 poolずつ1つのJSONにまとめられている。1つのJSONをアップすると30pool分のジョブが登録されるので気をつける。

1つのJSONを指定すると、合計30個のmgen_<NUM>ジョブが登録された。

複数ジョブ登録されているが、この状態ではまだ自動的にジョブが開始されていない可能性がある点に注意する。実際にジョブを実行するには、右端の三点リーダーボタンからサブミットを1個ずつクリックしていく必要がある。ここではcodexに代行させた。
出力例
pool1

pool2

対角線以外でも濃い部分が見られる。
pool3

pool4

pool5

4、最終結果。集計とサイズ正規化
AF3でそれぞれのpoolデータの構造予測が終わったら、AF3サーバーからzip形式でダウンロードする。解凍した全部のフォルダをpooled-af3の直下に配置して、*1、2のコードを実行する。
*1のコードの実行
=>出力例

(正規化前)
*2のコードの実行
=>。size_corrected_ipTM列で降順ソートして表示した。ここではpool1、2だけの最終結果を示している。

正規化後。相互作用候補は、size_corrected_ipTM列を確認する。値が高いペアほど、タンパク質サイズの影響を補正した後も相互作用らしいスコアが残っていることを示す。
論文より
- 意外な結果として、pooled-AlphaFold3は単に計算量を削減できただけでなく、2タンパク質だけを入力する通常のpairwise解析よりも相互作用予測精度が高くなった。STRINGの実験でのPPIを正解データとして比較すると、pooled-AlphaFold3のAUROCは強い相互作用で0.81、最も確実な相互作用では0.88だった。一方、同じタンパク質を2個ずつAlphaFold3に入力した場合は、それぞれ0.46、0.35まで低下した。
-
この差は主に偽陽性の減少によるものだった。複数のタンパク質を同時にAlphaFold3へ入力すると、相互作用候補同士が一種の競争をするため、単独ではもっともらしい複合体として予測されてしまう偽の相互作用が排除されると考えられた。実際、poolを2,000 aa、3,000 aa、4,000 aa、5,000 aaと大きくすると予測性能が徐々に向上し、5,000 aa程度まで大きくするほど偽陽性が減少した。
- AlphaFold3のipTMにはタンパク質サイズに依存する強いバイアスがあることが分かった。相互作用しないタンパク質同士であっても、2タンパク質の合計サイズが大きくなるほどipTMが高くなる傾向があった。このサイズ効果を補正しないraw ipTMでは既知PPIの判別性能がAUROC 0.34〜0.37しかなかったが、サイズ補正後には0.81〜0.88まで改善した。この傾向はpooled解析だけでなく通常のAlphaFold3やAlphaFold-Multimerのデータにも見られた。
- 全体のテストでは、476タンパク質から2,032 poolが作成され、30ジョブずつまとめたJSON 68個と、各ジョブのタンパク質対応表CSV 68個が生成された。
- 既知のPPIを再現しただけでなく、いくつかの新しい生物学的仮説も得られた。
- テストすると、構造的パラログが間違って高いスコアになることがあった。そこで、手動でPPIが分かっている配列AB(ヘテロテトラマーなので2コピーずつ)と、構造的パラログCを同じプールに入れて構造予測させてみた。するとA-C間のスコアは減少した。
コメント
この研究の面白いところは、複数タンパク質をまとめて投入することで計算速度を改善しながら、偽陽性まで減らしているところかと思います。自分は逆だと思ってました。小さな細菌ゲノムであれば、全タンパク質の組み合わせをAF3で調べ、PPIネットワークから未知遺伝子の機能を推定するフローが現実的になってきたと言えるかもしれません。
論文では合計2000以上のジョブが実行されていますが、実際に大規模に使う場合、サーバーの利用枠制限などに注意してください。現在の公式FAQでは、1日30ジョブまで、1ジョブ5,000 tokenまでとなっています。AF3サーバーには課金して利用枠を増やす仕組みはないので、これは全ユーザー共通のルールとなります。実際に1JSONファイル分ランしたところ、poolデータx20セットの計算に10時間ほどかかり、その後、さらに10時間ほどかけて残りの10セットの計算が進んでいきました。
実際に自分のデータで試す場合は、いきなり大規模な計算を行うのではなく、まず自分の中でポジコン、あるいはネガコンと分かっているものをpoolにしてランし、うまくいくことを確認してから慎重に進めた方がよいと思います。というのも、この方法の性質上、かなりサーバーに負担がかかるためです。スパコンなどの大規模計算機の使い方と同じで、まず小さな予備データで想定通りランできるか検証し、その後に本番の計算を行う、という意味です。無駄に大量の計算をさせないよう注意してください(場合によっては、アカウントが制限される可能性もあるかもしれません)。
ちなみに、AF3の公式ドキュメントでは、5,120 tokenまでの入力を単一のNVIDIA A100 80GBで処理できることを確認したと説明されています。ということは、GB200 NVL72のようなさらにウルトラハイエンドGPUサーバーがもし利用できるなら、より大規模なプール計算も可能になるかもしれませんね(注:AF3では、入力するアミノ酸残基数[token]が増えるほど、計算量とメモリ使用量が急激に増加します)。
追記
作者らの新作もプレプリントで出ているようです。気づきませんでした。
Predicting the protein interaction landscape of a mycobacterial pathogen | bioRxiv
"Todorらは以前、pooled-AlphaFold3を用いて、Mycoplasma genitaliumの476タンパク質について全113,050通りのタンパク質間相互作用(PPI)を網羅的に予測した。この手法をさらに大規模化し、本研究では、Mycobacterium lepraeのプロテオームについて約130万通りの全タンパク質ペアを解析した。その結果、約2,000のstrongまたはintermediate PPIが予測された。さらに、これらのPPIをMycobacterium tuberculosis、M. smegmatis、Corynebacterium glutamicumのchemical genomicsデータと統合することで、これまで機能が不明だった保存タンパク質の機能を推定した。"
引用
Predicting the protein interaction landscape of a free-living bacterium with pooled-AlphaFold3
Horia Todor, Lili M Kim, Jürgen Jänes, Hannah N Burkhart, Seth A Darst, Pedro Beltrao, Carol A Gross
Molecular Systems Biology. 2026;22:497–518.
Todorらのpooled-AlphaFold3 論文の解説
Proteome-wide AlphaFold pool party
Kevin Drew
Mol Syst Biol. 2026 Feb 17;22(4):477–479.
https://pmc.ncbi.nlm.nih.gov/articles/PMC13046886/
関連
*1
各ジョブのipTMを平均する
ジョブ名やファイル数を固定せず結果フォルダを自動的に探してAF3 Serverからダウンロードした結果を読み込み、各ジョブの複数モデルにおけるペア間ipTMを平均する。
#R
library(jsonlite)
# AlphaFold Serverの結果フォルダを自動取得
folders <- list.dirs(".", full.names = TRUE, recursive = FALSE)
folders <- folders[grepl("fold_mgen_[0-9]+$", folders)]
# test/内のジョブ説明ファイルを読み込む
description_files <- list.files("test", pattern = "^mgen[0-9]+[.]csv$", full.names = TRUE)
descriptions <- do.call(rbind, lapply(description_files, read.csv, row.names = 1, stringsAsFactors = FALSE))
for (folder in folders) {
folder_name <- basename(folder)
job_name <- sub("^fold_", "", folder_name)
csv_job_name <- sub("^mgen_", "mgen", job_name)
description <- descriptions[descriptions[, 1] == csv_job_name, 2]
protein_names <- unlist(strsplit(description, "::::", fixed = TRUE))
summary_files <- list.files(folder, pattern = "summary_confidences_[0-9]+[.]json$", full.names = TRUE)
iptm_matrices <- lapply(summary_files, function(file) {
fromJSON(file)"chain_pair_iptm"
})
mean_iptm <- Reduce("+", iptm_matrices) / length(iptm_matrices)
rownames(mean_iptm) <- protein_names
colnames(mean_iptm) <- protein_names
output_file <- paste0(job_name, "_iptm_raw_mean.csv")
write.csv(mean_iptm, output_file)
}
*2
複数のCSVから最終行列を作る。
ここからは、リポジトリのsize_correct関数とmake_matrix_all_by_all関数を使う。AlphaFold Serverの現在の出力形式に対応するため、JSONの読み込み部分だけを調整している。現在はmgen_1とmgen_2の2ジョブを対象にしているため、476×476行列の一部だけに値が入る。
#R
library(seqinr)
library(jsonlite)
source("analysis_functions.R")
# 解析対象のAlphaFold Server結果フォルダ
folders <- list.dirs(".", full.names = TRUE, recursive = FALSE)
folders <- folders[grepl("fold_mgen_[0-9]+$", folders)]
# poolとタンパク質名の対応表
description_files <- list.files("test", pattern = "^mgen[0-9]+[.]csv$", full.names = TRUE)
descriptions <- do.call(rbind, lapply(description_files, read.csv, row.names = 1, stringsAsFactors = FALSE))
# 各poolの5モデルから平均ipTM行列を作成
iptm_results <- list()
for (folder in folders) {
folder_name <- basename(folder)
job_name <- sub("^fold_", "", folder_name)
csv_job_name <- job_name
description <- descriptions[descriptions[, 1] == csv_job_name, 2]
protein_names <- unlist(strsplit(description, "::::", fixed = TRUE))
summary_files <- list.files(folder, pattern = "summary_confidences_[0-9]+[.]json$", full.names = TRUE)
iptm_matrices <- lapply(summary_files, function(file) {
fromJSON(file)"chain_pair_iptm"
})
mean_iptm <- Reduce("+", iptm_matrices) / length(iptm_matrices)
if (length(protein_names) != nrow(mean_iptm)) {
stop(paste("タンパク質数が一致しません:", job_name))
}
rownames(mean_iptm) <- protein_names
colnames(mean_iptm) <- protein_names
iptm_resultsjob_name <- mean_iptm
write.csv(mean_iptm, paste0(job_name, "_iptm_raw_mean.csv"))
}
# 全タンパク質配列
proteins <- read.fasta("mgen_proteins.txt", forceDNAtolower = FALSE, as.string = TRUE)
# リポジトリのsize_correct関数でサイズ補正
size_corrected <- size_correct(
iptm_results,
proteins,
coefs = c(-0.036255571, 0.004470512)
)1
# リポジトリのmake_matrix_all_by_all関数で行列化
final_results <- make_matrix_all_by_all(
size_corrected,
proteins,
resolve_reps = "mean"
)
write.csv(final_results1, "mgen_iptm_size_corrected_mgen1_mgen2.csv")
write.csv(final_results3, "mgen_iptm_raw_mgen1_mgen2.csv")
write.csv(final_results5, "mgen_pair_summary_mgen1_mgen2.csv", row.names = FALSE)
参考
Predicting the protein interaction landscape of a free-living bacterium with pooled-AlphaFold3
— Biology+AI Daily (@BiologyAIDaily) July 5, 2025
1.A new method called pooled-AlphaFold3 enables large-scale prediction of protein-protein interactions (PPIs) across entire genomes using AlphaFold3, cutting inference jobs ~100-fold… pic.twitter.com/QvCsVpkANa
2026/09/01 追記
AlphaFold-Multimerを、構造予測ではなく「機能未知タンパク質の探索」に使った研究
DOI: 10.1038/s41467-026-77112-z
URL: https://doi.org/10.1038/s41467-026-77112-z
ヒトのミトコンドリアタンパク質1,123個について、630,003通りのペアをほぼ総当たりで複合体予測し、2,895の相互作用候補を抽出。その結果、85個の機能未知タンパク質に相互作用相手を割り当て、既知の代謝・生化学経路との関連を推定し、実験的な検証も行っている。
技術的には、AlphaFold-Multimerで二者複合体を総当たり予測している。各ペアについて5つのmultimer modelを計算し、その平均ipTMを用いて相互作用候補をスクリーニングしている(mean ipTMの方がfalse positiveを減らせることを予備実験で確認している)。得られた高スコアの相互作用からネットワークを構築し、機能未知タンパク質を既知の複合体や代謝経路に結び付けている。AF3 Multimerのような方法は使っておらず、HPC clusterを使って力技で予測を行っている。また、著者らはMSA depthを非常に重視していて、実際にPPI判定性能の最大の決定要因はMSA depthであり、MSA depth >25くらいからかなり性能が良くなると報告している(AF3サーバーではサーバーサイドで自動でMSAが構築されるため、ユーザーがMSAを用意する必要はない)。
また、630,003ペアすべてのipTMスコアを含むデータも公開されている。
