比較ゲノミクスや進化研究から精密育種に至るまで、現代のゲノミクスにおいて染色体レベルのアセンブリは不可欠である。HiFiデータとHi-Cデータを統合することで、現在では高精度な染色体スケールのゲノムアセンブリが可能になっているが、そのバイオインフォマティクス処理は依然として複雑であり、専門的なツールや知識を必要とする。数十から数百もの「プラチナ品質(極めて高品質)」な染色体スケールゲノムを必要とする大規模なパンゲノム解析プロジェクトが進む中、高品質なゲノムアセンブリのワークフローを効率化・標準化し、かつスケーラブルでポータブル、そしてユーザーフレンドリーなパイプラインが求められている。
本論文では、PacBio HiFiデータとHi-Cデータを用いた染色体スケールのデノボゲノムアセンブリを行うための、コンテナ化されたスケーラブルなパイプラインPuzzlerを紹介する。ポータビリティとユーザー入力の最小化を重視して設計されたPuzzlerは、コンティグのアセンブリ、重複配列の除去(duplicate purging)、Hi-Cデータに基づくスキャフォールディング、そして(参照種と大きく異なる分類群であっても)シンテニー(遺伝子配列の保存性)を利用した染色体への割り当てを自動化する。オプションモジュールを使用することで、手動でのHi-Cキュレーション用入力ファイルの生成や、参照配列を使用しない(リファレンスフリーな)解析も可能となっている。品質管理機能も統合されており、Hi-Cコンタクトマップ、BUSCO、yakによるk-mer完全性評価、BlobToolsによるコンタミネーションスクリーニングなどが含まれる。チェックポイント機能により、完了済みのタスクが再実行されるのを防ぐ一方、シンプルなサンプルシート形式の入力構造により、スケーラブルなバッチ処理をサポートしている。Puzzlerは24 Mbpから6.5 Gbpの範囲のゲノムで検証されており、10分未満のユーザー入力で高い連続性を持つアセンブリを実現し、プラチナ品質のゲノムアセンブリをハイスループットに行うことを可能にする。
Puzzlerは、米国著作権法第105条に基づきパブリックドメインとして公開されている。ソースコード、ドキュメント、チュートリアルはhttps://github.com/merondun/puzzler で入手可能であり、Zenodo(https://doi.org/10.5281/zenodo.15733730および https://doi.org/10.5281/zenodo.15693025)にもアーカイブされている。依存関係を含む設定済みの実行環境は、Conda環境(https://anaconda.org/heritabilities/puzzler)およびApptainer(ZenodoおよびSylabsでホスト: (https://cloud.sylabs.io/library/merondun/default/puzzler)の両方で提供されている。
インストール
windows11のWSLでmambaで環境を作って導入した。
Github
mamba create -n puzzler -c conda-forge -c bioconda -c hcc -c heritabilities puzzler -y
conda activate puzzler

#apptainer(singularity)イメージとしても配布されている (レポジトリ参照)
> puzzler -h
Usage (v2.0.1): puzzler -s sample -m samples.tsv [OPTIONS]
Options:
-s, --sample SAMPLE Sample name, corresponding to the first column in the map file (required)
-m, --map FILE Path to .tsv/.csv map file (required)
--threads t Number of threads (optional; default 48)
--mem MEM Memory allocation (optional; default 512)
--no_purge Skip purge duplicates step entirely (optional)
--no_juice Skip juicer file creation entirely (optional; not recommended!)
--yahs Run scaffolding with YAHS directly instead of HapHiC (optional)
-v, --version Show version and exit
-h, --help Show help and exit
Required --map Structure:
The provided map file (e.g., samples.tsv) must contain the following columns in this order:
SAMPLE RUNTIME CONTAINER WD HIFI HIC_R1 HIC_R2 NUM_CHRS REFERENCE HOM_COV FCS_DB FCS_TAXID BUSCO_LINEAGE BUSCO_DB
For optional columns (REFERENCE - BUSCO_DB), write NA if undesired.
実行方法
ランするにはサンプルシートのCSVが必要
puzzler/examples/samples.tsv

codex (5.5 middle) による解説
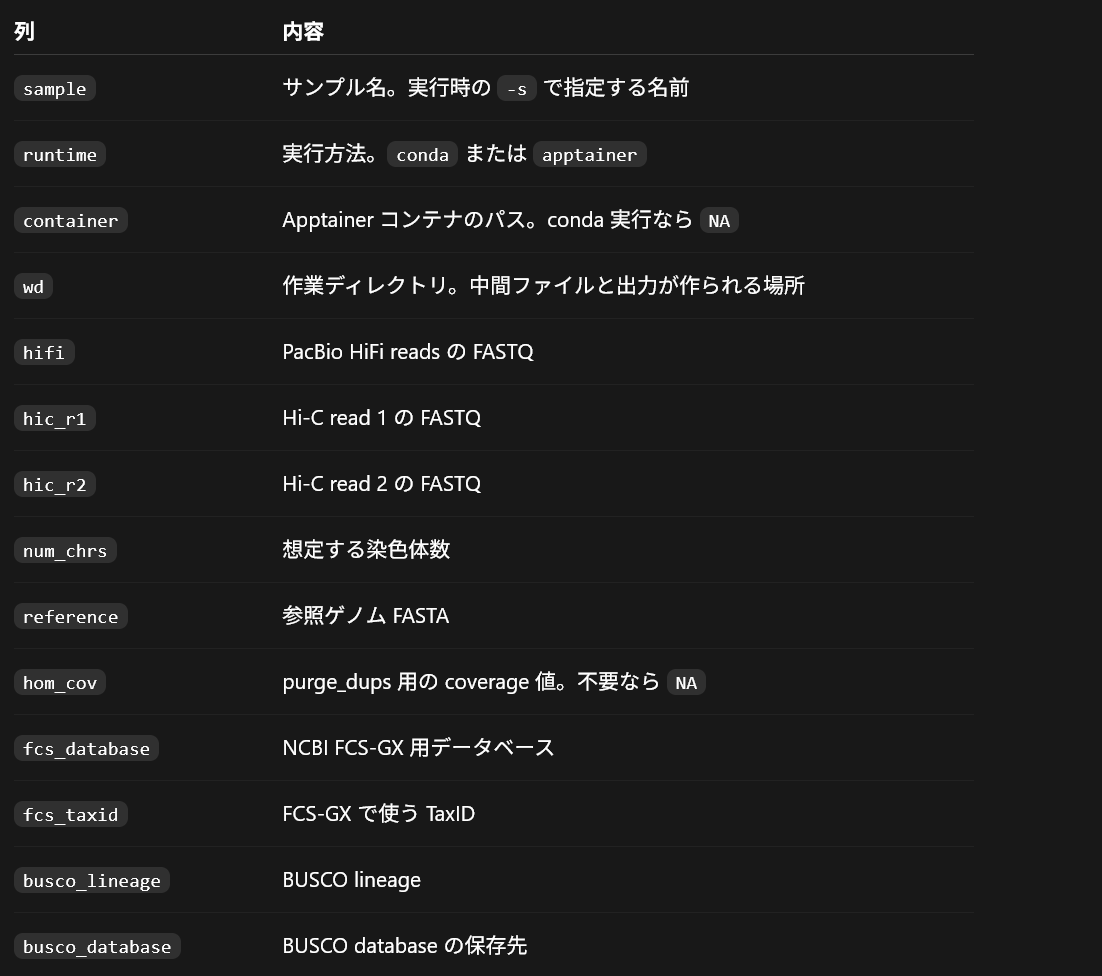
レポジトリで説明されているアセンブリプロセス
このパイプラインは、HiFiデータとHiCデータの両方を使用して、冗長性が排除されたプライマリゲノムアセンブリを作成する。Puzzlerのワークフローは、前半のラン(step 1)、HiCコンタクトマップについて、GUIツールによるscaffoldsエラーのチェックと品質改善(step 2)、手修正したアセンブリファイルを使った再出力の生成とQCラン(step 3)の3段階で行うことが推奨されている (ステップ2は任意、1コマンドでも全過程を出力可能)。
ステップ1 - Puzzlerの1回目ラン。用意したサンプルシートを指定する。20スレッド指定、256GBメモリ割り当て (デフォルトは48スレッド、512GBメモリ割り当て)。logが重要なので標準出力しつつ記録しておく。
puzzler -s Fungus_Test -m samples.tsv --threads 20 --mem 256 2>&1 | tee puzzler.log
- -s Sample name, corresponding to the first column in the map file (required)
- -m Path to .tsv/.csv map file (required)
- --threads Number of threads (optional; default 48)
- --yahs Run scaffolding with YAHS directly instead of HapHiC (optional)
- --mem Memory allocation (optional; default 512)
Puzzlerの前半のワークフローは以下の通り
- HiFiおよびHi-Cリードを用いたHifiasmによるアセンブリ。
- purge_dupsを使用したハプロティグ(重複領域)の除去。通常、二倍体生物において十分なHiFiデータがあれば、Hifiasmはカバレッジに基づいて大部分の重複領域を適切に除去する。このpuzzlerの実装はカバレッジではなく配列の類似性に基づいている。この手法は倍数体を含む多くの種で有効であり、HiFiリードの再マッピングを必要としない (このステップは--no_purgeを付けることで省略可能)。この処理は通常、小さなコンティグにのみ影響し、染色体レベルのスキャフォールドには影響しない。
- HapHiCによるスキャフォールディング(HapHiCが失敗した場合はYAHSが使用される。--yahsを指定すると直接YAHSへ移行)。
- Juiceboxでの手動キュレーション用入力ファイル(.hic, .assembly)の作成(--no_juice指定時はスキップされる)。
1-4までの流れを1回目のランで行い、出てきたファイルをJuiceboxのGUIでチエックする(下で説明)。
ステップ1の初期アセンブリが一番時間がかかる。

このデータでは、途中でHapHiCによるscaffoldingステップで、染色体数14を仮定してscaffoldを構築するところでエラーを吐いている (samples.tsvのNUM_CHRS列に14と書いている)。Puzzlerは、その失敗を検出し、染色体数の仮定を変えながらHapHiCを再試行している。

HapHiCは14~18本までの染色体数仮定でscaffoldingを試してエラーを出し、その後最終的にPuzzlerはYAHS(別のscaffoldingツール)を使ってscaffoldを構築した。
出力例

終わると、samples.tsvのWDに指定した作業ディレクトリ内に中間ファイルが作成され、Juicebox用ファイルは以下に出力される。
- ${WD}/juicer_files/${SAMPLE}_JBAT.hic
- ${WD}/juicer_files/${SAMPLE}_JBAT.assembly
Fungus_JuiceTest/ #中間ファイルを含む作業ディレクトリ

primary_asm/ : 最終出力のパス。現在はstatsのみで空

juicer_files/ : 上で説明したディレクトリ

ステップ2 - JuiceboxにHi-Cコンタクトマップを可視化して、scaffoldingエラーを修正する。
Puzzlerは、1回目のランが終わると、Hi-Cスキャフォールディング後のゲノムアセンブリをJuiceboxで確認できるように、.hicファイルと.assemblyファイルを出力する。この2つをJuicebox Assembly Tools (Juiceboxに組み込まれているGUIツール、Hi-Cコンタクトマップを見ながらゲノムアセンブリを手動修正するソフト) に読み込み、Hi-Cコンタクトマップを見ながら、染色体スケールのスキャフォールドに誤りがないか調査する。
JuiceboxGUIはGithub releaseからダウンロードする。
https://github.com/aidenlab/JuiceboxGUI/releases?utm_source=chatgpt.com
Juiceboxを起動する。javaが必要。最近のバージョンだとやや不安定なので、ここでは仮想環境に古いjavaを入れて使う。
mamba create -n juicebox_java8 -c conda-forge openjdk=8 -y
conda activate juicebox_java8
java -Xms512m -Xmx4g -jar <path>/<to>/juicebox.jar

File openでFungus_JuiceTest_JBAT.hicを指定

読み込まれた。

import map assemblyでアセンブリを読み込む。ほかの近縁リファレンスも指定できる。
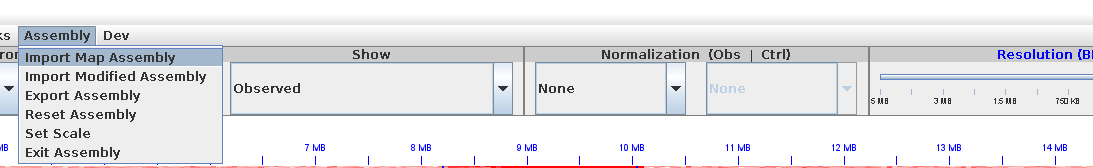
画面ドラッグで移動、ダブルクリックで拡大する。

Show => observed
Normalization => balanced
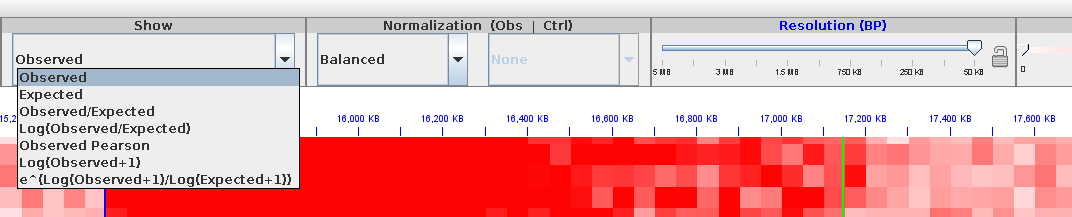
=>
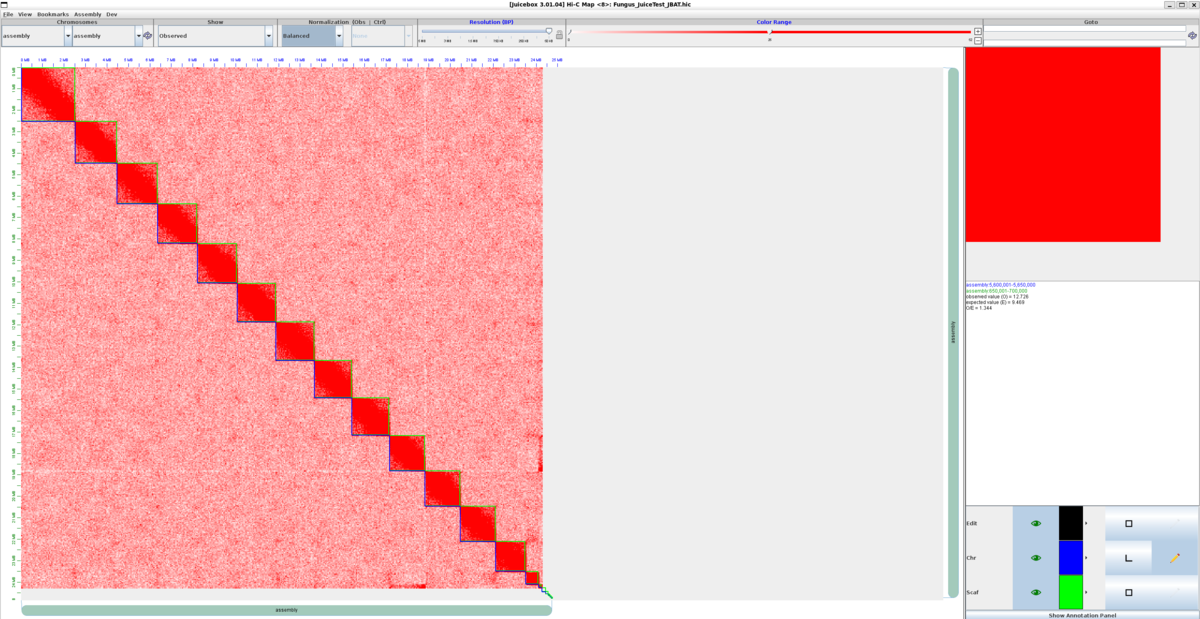
右下にはphotoshopのレイヤーのようなパネルがある。
Edit Juicebox で切断・反転・移動などをした編集内容を扱う。黒線の境界
Chr chromosome / superscaffold 単位の表示。大きな染色体スケールのまとまり。青線の境界
Scaf scaffold / contig 単位の表示。より細かい元 scaffold の区切り。緑線の境界
切断するには、起点となる対角線状でシフト+左クリックし、そのままどちらもボタンも離す。

次に分断したい側の境界線(青や緑)に移動して、アイコンの形が「 または 」に変わったらシフトを押さず左クリックする。新しい緑の枠が出現して、クリック部位と既存の境界線を1単位としてscaffoldが分断される (図は適当に切っている)。

間違ったときはCtrl+Uでundo
以下の動画では、Juiceboxによるチェックの流れを11個のゲノムで説明している。ただし音声がない。
11ゲノムの簡易キュレーション例
Juiceboxでは、.hicファイルと.assemblyファイルの2つを重ねて表示することで、現在のアセンブリ構造がHi-Cデータによって支持されているかを視覚的に確認できる。以下のような機能がある。
- scaffoldやcontigの誤結合を切断する
- 配列断片の順序を入れ替える
- 配列断片の向きを反転する
- 複数の断片を同じ染色体候補としてまとめる
- 修正後の配置情報を .assembly ファイルとして保存する
最初に確認しているのは、1本のscaffoldの内部に、Hi-Cデータで支持されていない結合が含まれていないかどうか。誤結合が存在すると、対角線上のシグナルがその位置を境に急に弱くなり、左右の領域間にほとんどHi-Cコンタクトが見られなくなる。このような位置では、誤って連結されたscaffoldをJuicebox上で切断する (ただし、セントロメア、反復配列、低マッピング領域領域でもシグナルが弱くなるので、判定は慎重に行う)。動画では、例えば23:30ぐらいにコンタクトマップの濃い領域が2つに分かれている染色体(青いboxが1個の染色体領域)を見つけて、23:45付近で別々の染色体に分ける操作をしている。

間違ったときはCtrl+Uでundoできる。
誤ったscaffoldingを切ったら、次に、scaffoldまたはcontigの並び順を確認する。あるscaffoldが別のscaffoldと強いHi-Cコンタクトを示している場合、それらは同じ染色体上で隣接している可能性が高いので、正しい順序に並べ替える (画面上でブロックを選択してドラッグし、別の位置へ移す操作。離れた位置に存在していたシグナルが連続した対角線状に移動する)。動画だと、例えば25:16付近で対角線に沿って出現しないシグナルを検出している。

チェックと編集が一通り終わったら、Juiceboxで行った編集内容を反映させたassembly ファイル (.fastaでなくJuiceboxのassembly情報ファイル形式: scaffold の並び・向き・切断/結合の情報が入っている) を出力する。
Juiceboxで修正して書き出した .assemblyファイルを、最終的にこの名前でjuicer_files/に配置する。
mkdir -p ${WD}/juicer_files
mv Juicebox.assembly ${WD}/juicer_files/${SAMPLE}_JBAT.review.assembly
ファイル名はPuzzlerが決め打ちで参照するため、${SAMPLE}_JBAT.review.assemblyにする必要がある。
ステップ3 - Puzzlerの2回目ラン。Juiceboxで手動修正した .assembly ファイルを取り込んで、最終アセンブリファイルとQCを行う。このコマンドの実行前に、Juiceboxで修正したファイルが上の説明通りディレクトリに配置されていること。
conda activate puzzler
puzzler -s ${SAMPLE} -m ${WD}/samples.tsv
以下のフローで進められる。
- 最終アセンブリ:Juicer形式のアセンブリを抽出、近縁種の参照配列に基づいて染色体名を割り当て(`>Chr` または `>chr` で始まるスキャフォールドのみ対象)、merothonを使用して逆相補鎖(reverse complement)の調整を行う。
- QC1: fcs-gxによるNCBI汚染(コンタミ)スクリーニングと除去(オプション:データベースへのパスが指定された場合)
- QC2: HapHiCを用いた最終アセンブリ確認のためのHiC再マッピング
- QC3: merquryによるk-merベースのゲノム完全性チェック
- QC4: BUSCO値チェック(オプション:データベースパス指定が必要)
- QC5: bbstats.shによるアセンブリ統計メトリクスチェック
Fungus_JuiceTest/ : 作業ディレクトリ

primary_asm/ : 最終出力

Fungus_JuiceTest.fa.fai - 14個の染色体レベルアセンブリ、8個のscaffoldレベルアセンブリ

primary_asm/stats/Fungus_Test.HiC_contacts.pdf

Hi-Cでは、ゲノム上で近接する領域ほど互いに接触しやすく、多くのHi-Cリードペアが検出される。コンタクトマップでは、同じ位置または近接した位置同士の比較が対角線付近に表示されるため、染色体が正しい順序と向きで組み立てられていると、対角線に沿って強いシグナルが途切れずに続く。反対に、配列の順序や向きが誤っている場合や、別の染色体の配列が誤って連結されている場合には、シグナルが途中で途切れたり、対角線から離れた位置に不自然な強いシグナルが現れる (この論文のFig.2参照: Fig.2A,Cが修正前、Fig.2B、Dが修正後。Fig2には横に並んで2つずつ図があるが、左が本図、右側は拡大図。対角線がX字状になっている部分がおかしいところ)。
その他
- --no_juiceを付けると、JuiceboxでHi-C contact mapを見て染色体スキャフォールドを手動で点検・修正するためのファイル作成ステップがスキップされる (非推奨)
- レポジトリでは、テストデータとしてRhizosphaera kalkhoffii (*1 )のPacBio Revio HiFiロングリードとillumina Hi-Cペアエンドリードを使ってテストしている。レポジトリでは、この同じデータを使ってリファレンスゲノムありなし、Juiceboxありなし合計4パターンをtestしている (注; 4パターン全てでHi-Cデータを使ってcontigを連結、ソート、まで共通)。結果、アセンブリ統計はこの4パターンでほぼ変化がなく、いずれのパターンでも高品質アセンブリを得られた。しかし、Juiceboxを使うことで、リファレンスに頼らず、1箇所、同じ染色体に由来する2ブロックを連結することに成功している (*2)。さらに、Juicebox+リファレンスゲノムありバージョンは、リファレンスゲノムを参照して組み立てた染色体の向きと順番を整えている (リファレンスゲノムを使ってref. guided assemblyやエラー修正をしたという意味ではないと思われる)。
引用
Puzzler: scalable one-command platinum-quality genome assembly from HiFi and Hi-C
Justin Merondun , Qingyi Yu
Bioinformatics Advances, Volume 6, Issue 1, 2026
関連
*1
Rhizosphaera kalkhoffii (GCA_964106605.1) はハプロイドゲノムサイズ25Mb,14染色体+Mtゲノム からなる。
*2
手作業で直す価値があるということ。ただし、この菌類データでは元のYAHS結果がよく、Juiceboxで必要だった修正も1か所だけだった。
